Ocena narzędzia lub SaaS
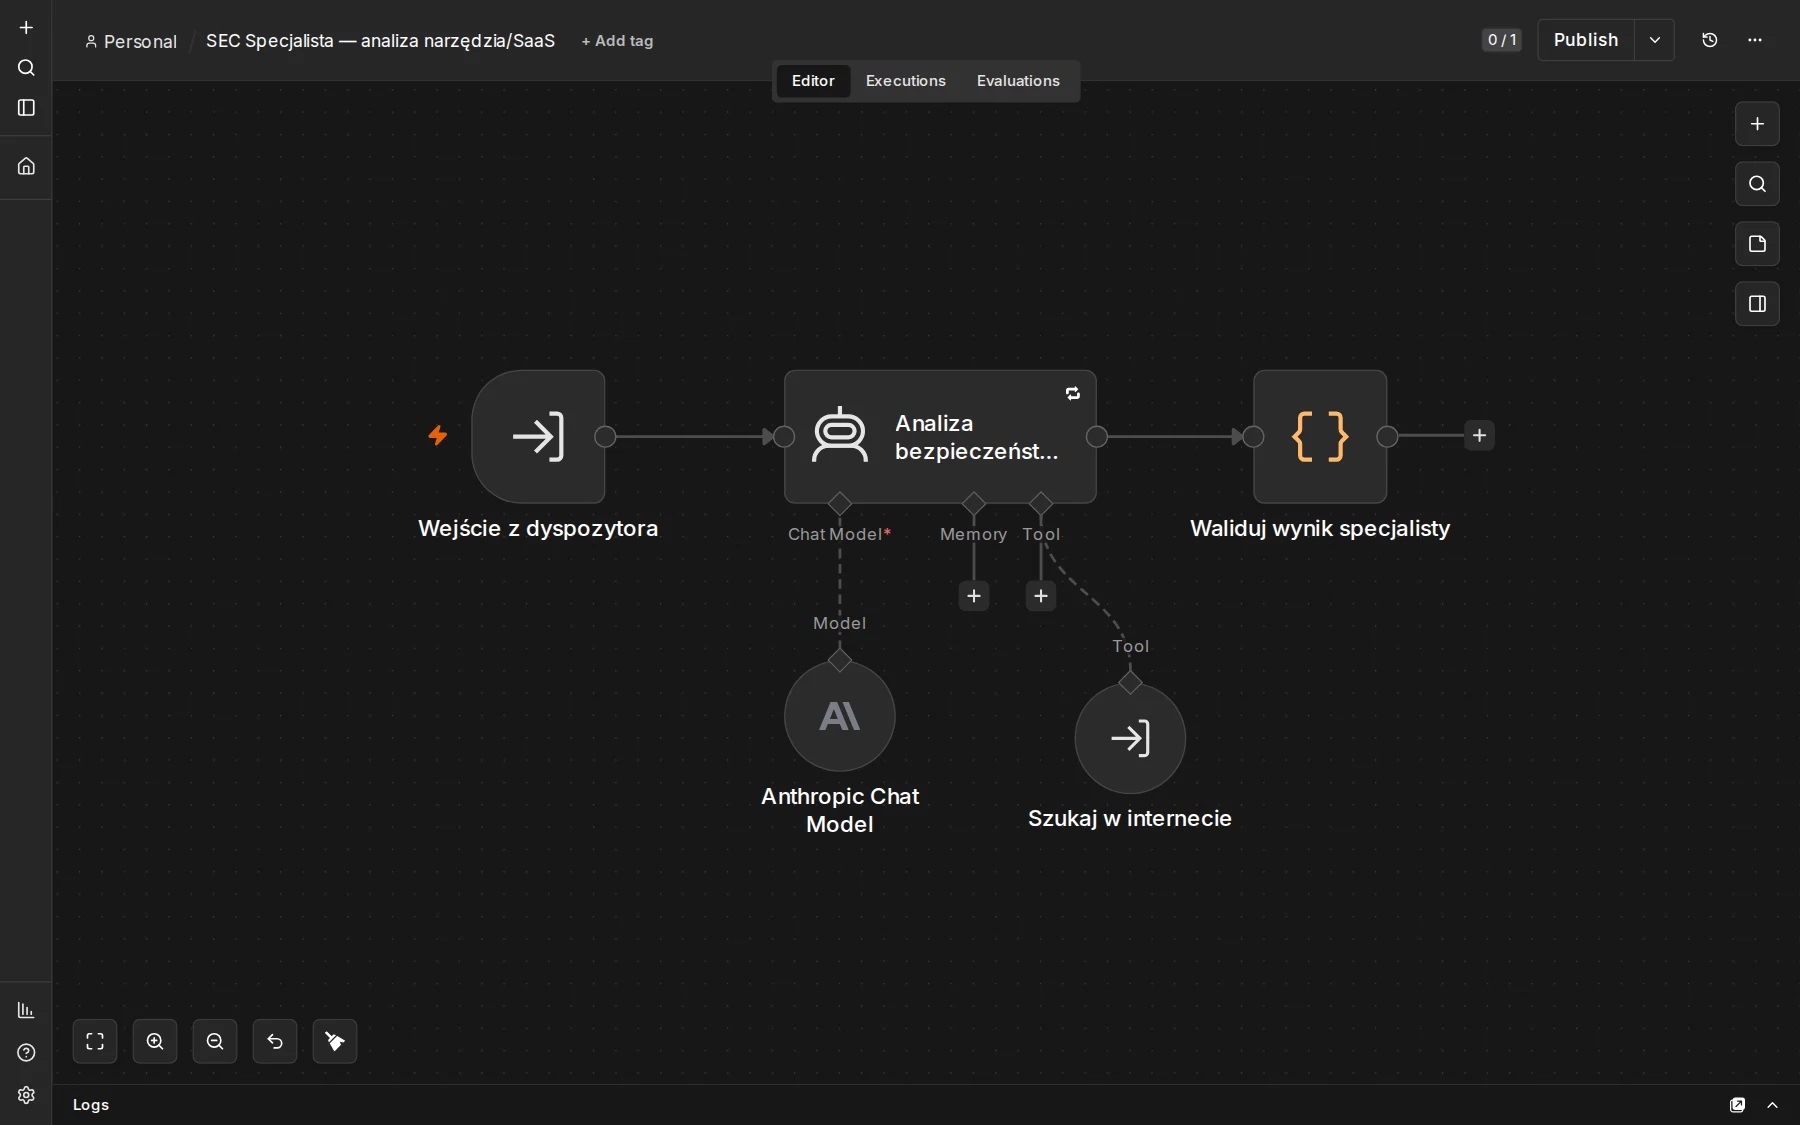
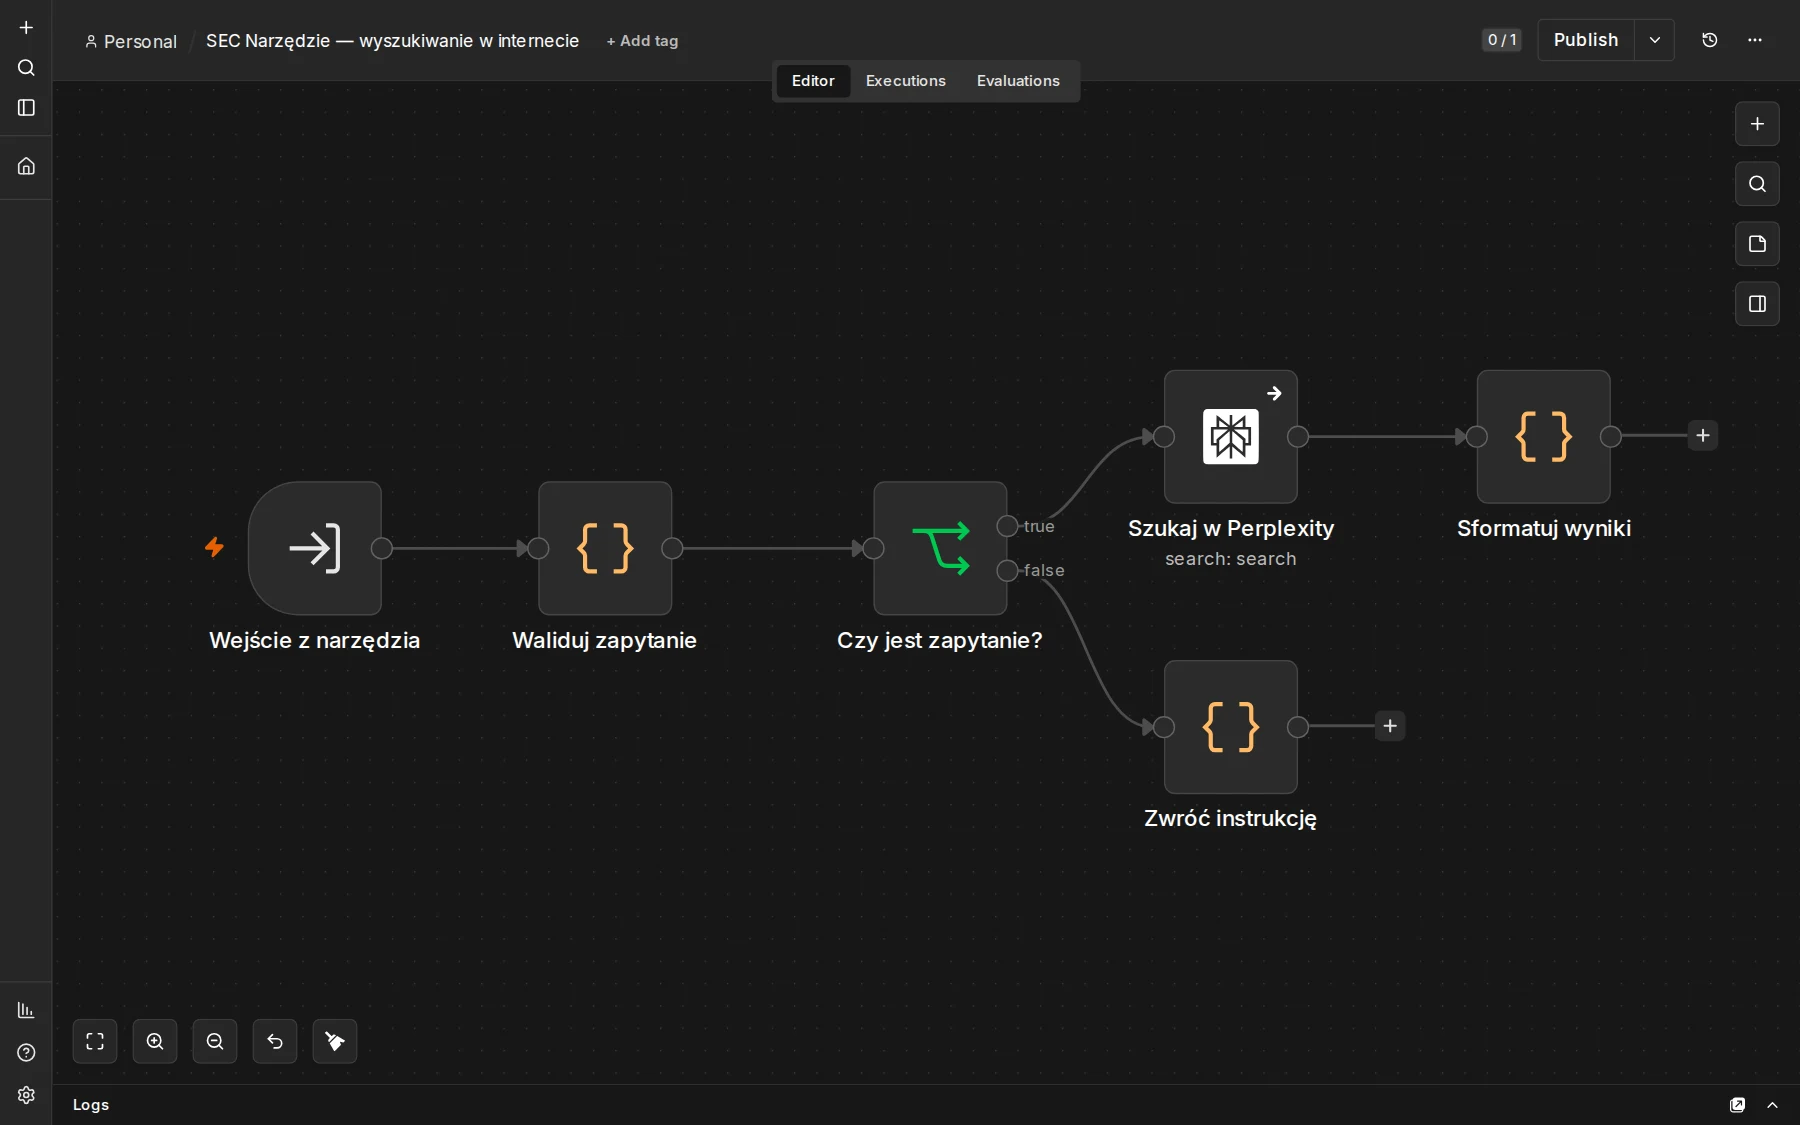
Ktoś chce wprowadzić narzędzie. Produkt: rekomendacja dopuszczenia z warunkami. Ten agent jako jedyny dostał wyszukiwanie w internecie, bo zgłoszenie zwykle zawiera tylko nazwę.
case study · automatyzacja n8n z agentami AI
Dyspozytor w n8n co 30 minut czyta nowe i zmienione zadania z Jiry, robi triage modelem AI i przekazuje zadanie jednemu z trzech wyspecjalizowanych agentów. Inżynier dostaje gotową ocenę ryzyka, opinię o narzędziu albo szkic procedury, a gdy AI nie ma nic do dodania, dostaje uczciwe „tu trzeba wejść do systemów”.
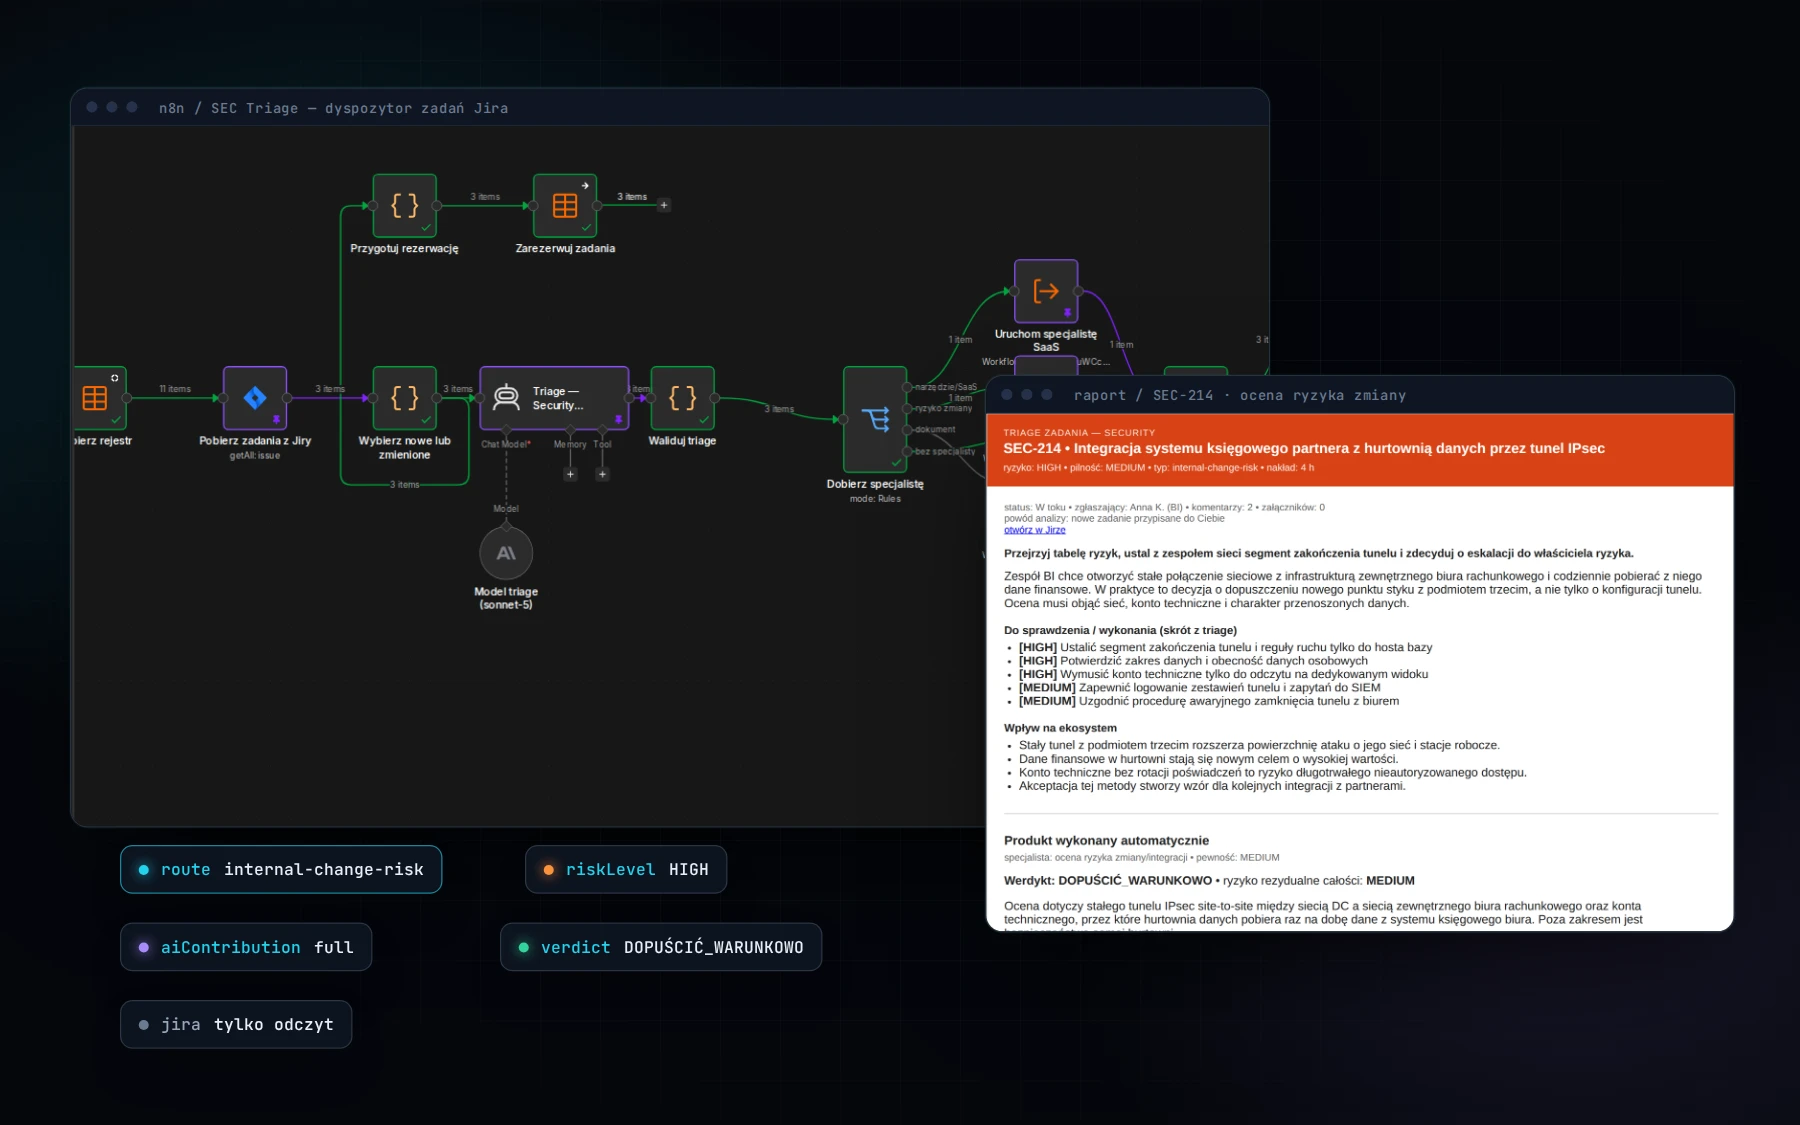
01 / punkt wyjścia
Inżynier bezpieczeństwa dostaje w Jirze zadania od całej firmy: opinie o narzędziach, oceny ryzyka zmian, procedury, weryfikacje w systemach. Zanim zaczyna się właściwa praca, trzeba zrozumieć zgłoszenie, ułożyć listę kontrolną i ocenić wpływ na resztę infrastruktury. Ten etap powtarzał się przy każdym zadaniu.
„Chcemy używać narzędzia X, czy można?” To typowy opis. Kontekst trzeba zbudować samemu: kto stoi za narzędziem, gdzie trzyma dane, co z SSO.
Ocena narzędzia, formalna ocena ryzyka i szkic polityki to trzy różne produkty, choć w Jirze wszystkie są po prostu „Zadaniem”.
Ważne ustalenia pojawiają się w wątku tygodnie po założeniu zadania. Nowy komentarz powinien uruchomić analizę ponownie, z pełnym kontekstem.
Warunek od początku: automat tylko czyta. Nie zmienia statusów, nie komentuje, nie przypisuje. Wynik ma trafić do człowieka, nie do zgłaszającego.
Weryfikacja MFA czy inwentaryzacja urządzeń to praca w systemach. Wypracowanie AI o tym, „jak ważne jest MFA”, byłoby gorsze niż brak odpowiedzi.
n8n działa wyłącznie w sieci wewnętrznej i przez VPN, więc Jira Cloud nie może wywołać webhooka. Zostaje cykliczne odpytywanie.
02 / wskaźniki
Dane z rejestru analiz od sierpnia do listopada 2026. Liczone ostatnie analizy każdego zadania.
Typ pracy to ocena modelu, nie pole z Jiry. Ten sam typ może trafić do różnych specjalistów albo do żadnego: o uruchomieniu specjalisty decyduje osobno ocena wkładu AI.
03 / analiza korpusu
Zamiast zgadywać, jakich specjalistów potrzeba, osobny jednorazowy workflow pobrał wszystkie zadania inżyniera (38), łącznie z zamkniętymi, i dał je modelowi do pogrupowania według rodzaju pracy, a nie słów w tytule. Dla każdej grupy model miał uczciwie ocenić, co AI zrobi bez dostępu do systemów firmy.
Ktoś chce wprowadzić narzędzie. Produkt: rekomendacja dopuszczenia z warunkami. Ten agent jako jedyny dostał wyszukiwanie w internecie, bo zgłoszenie zwykle zawiera tylko nazwę.
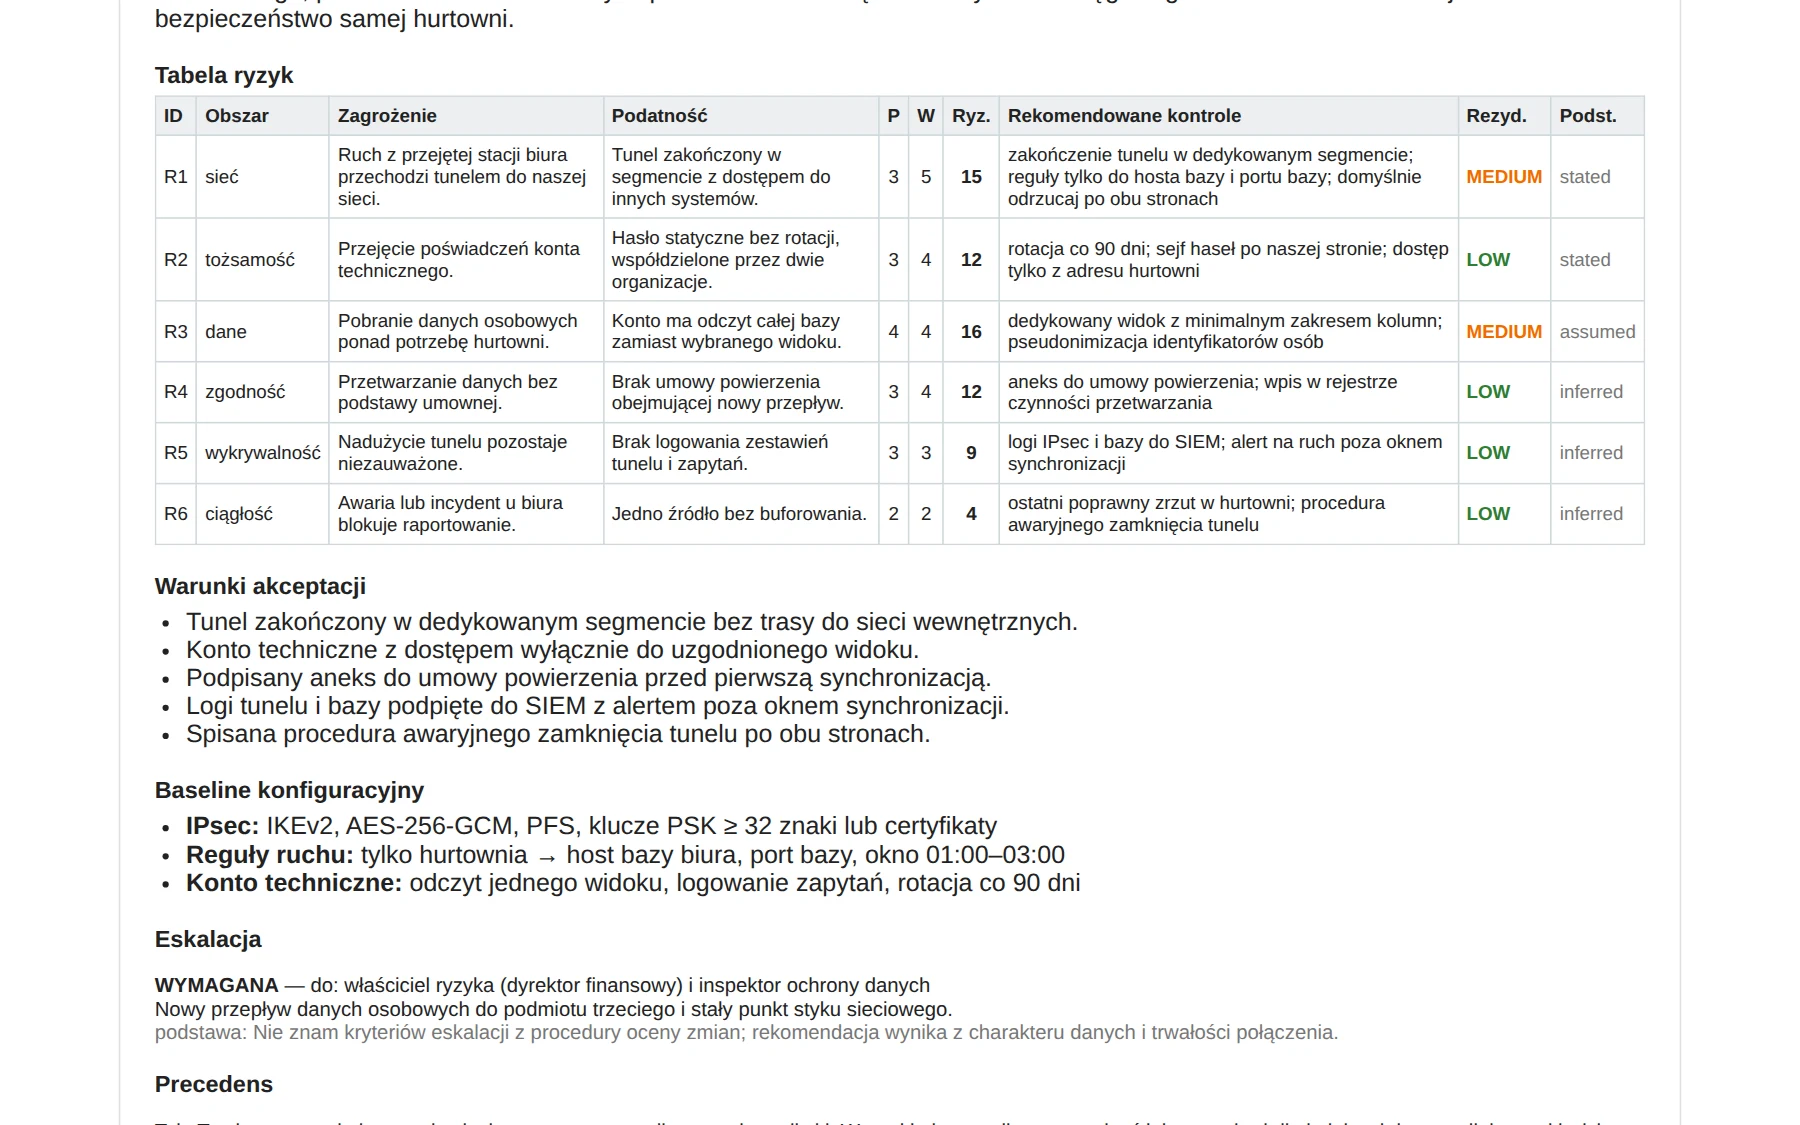
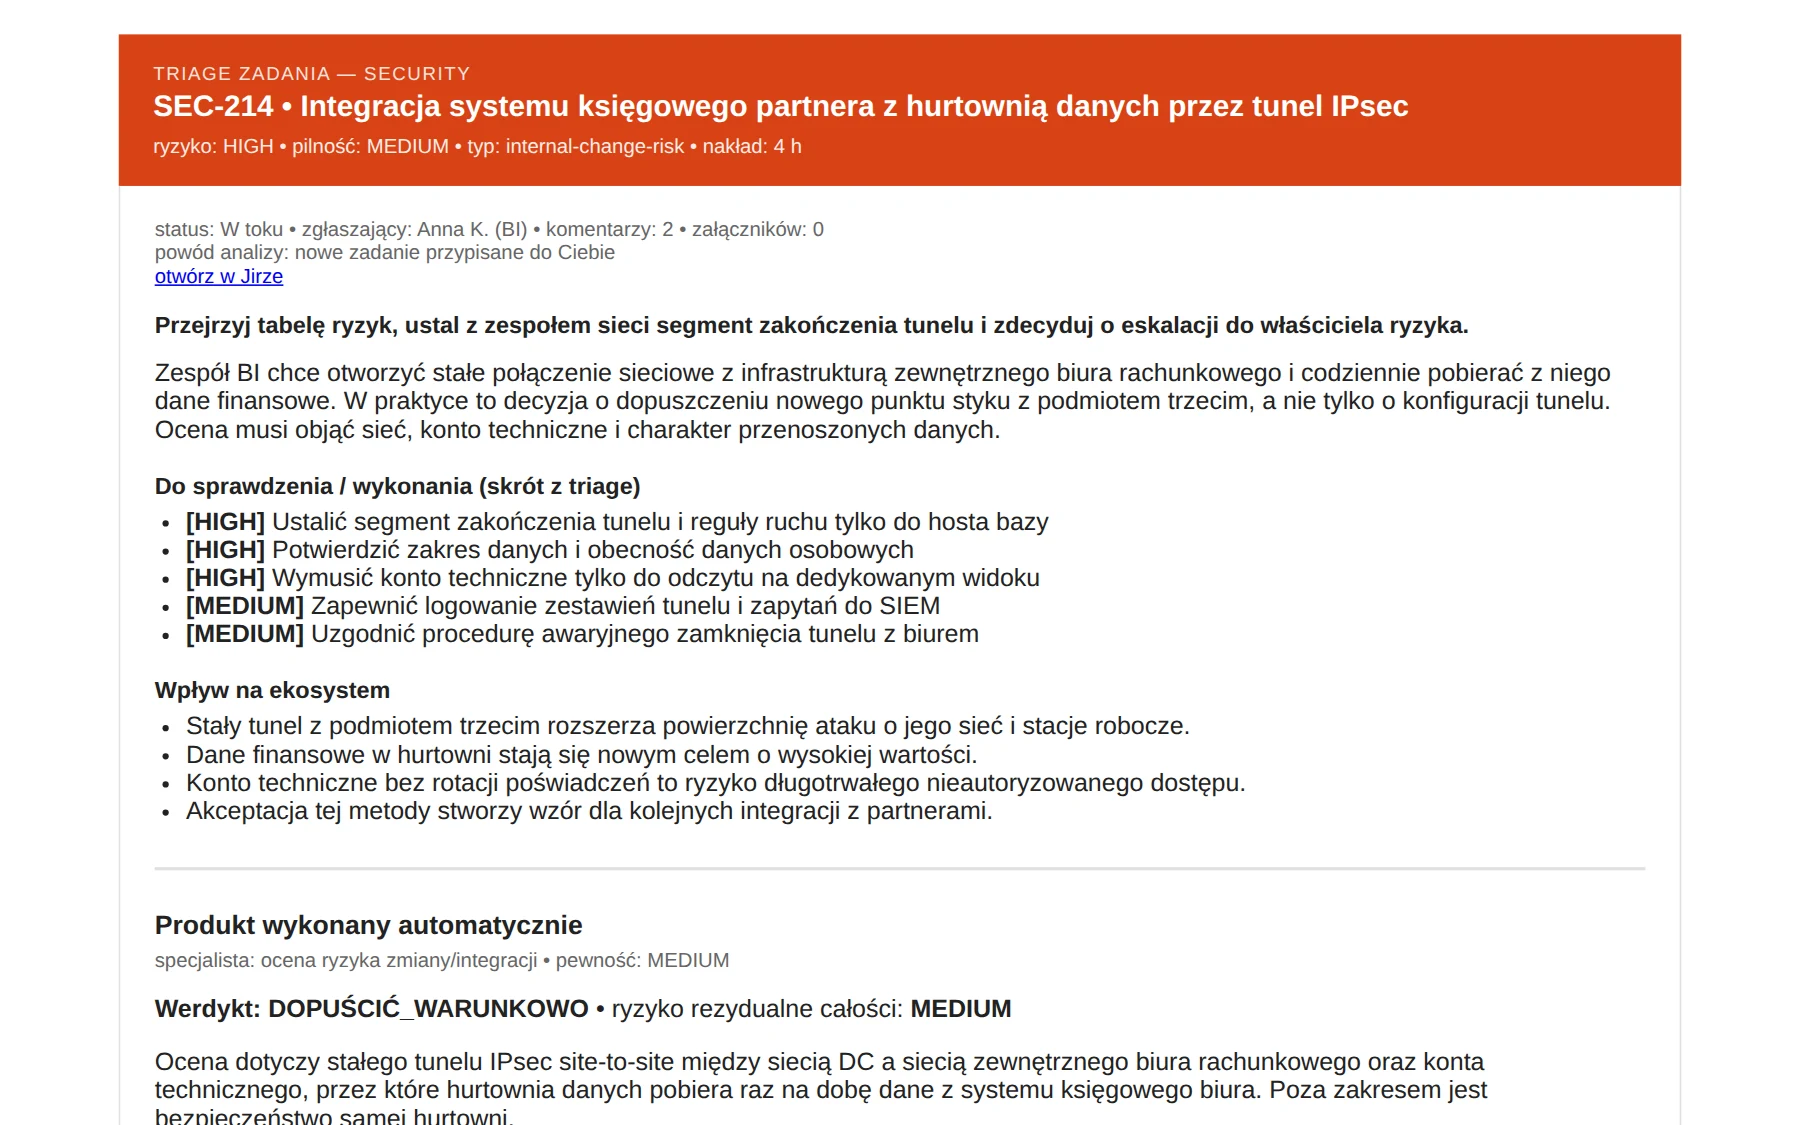
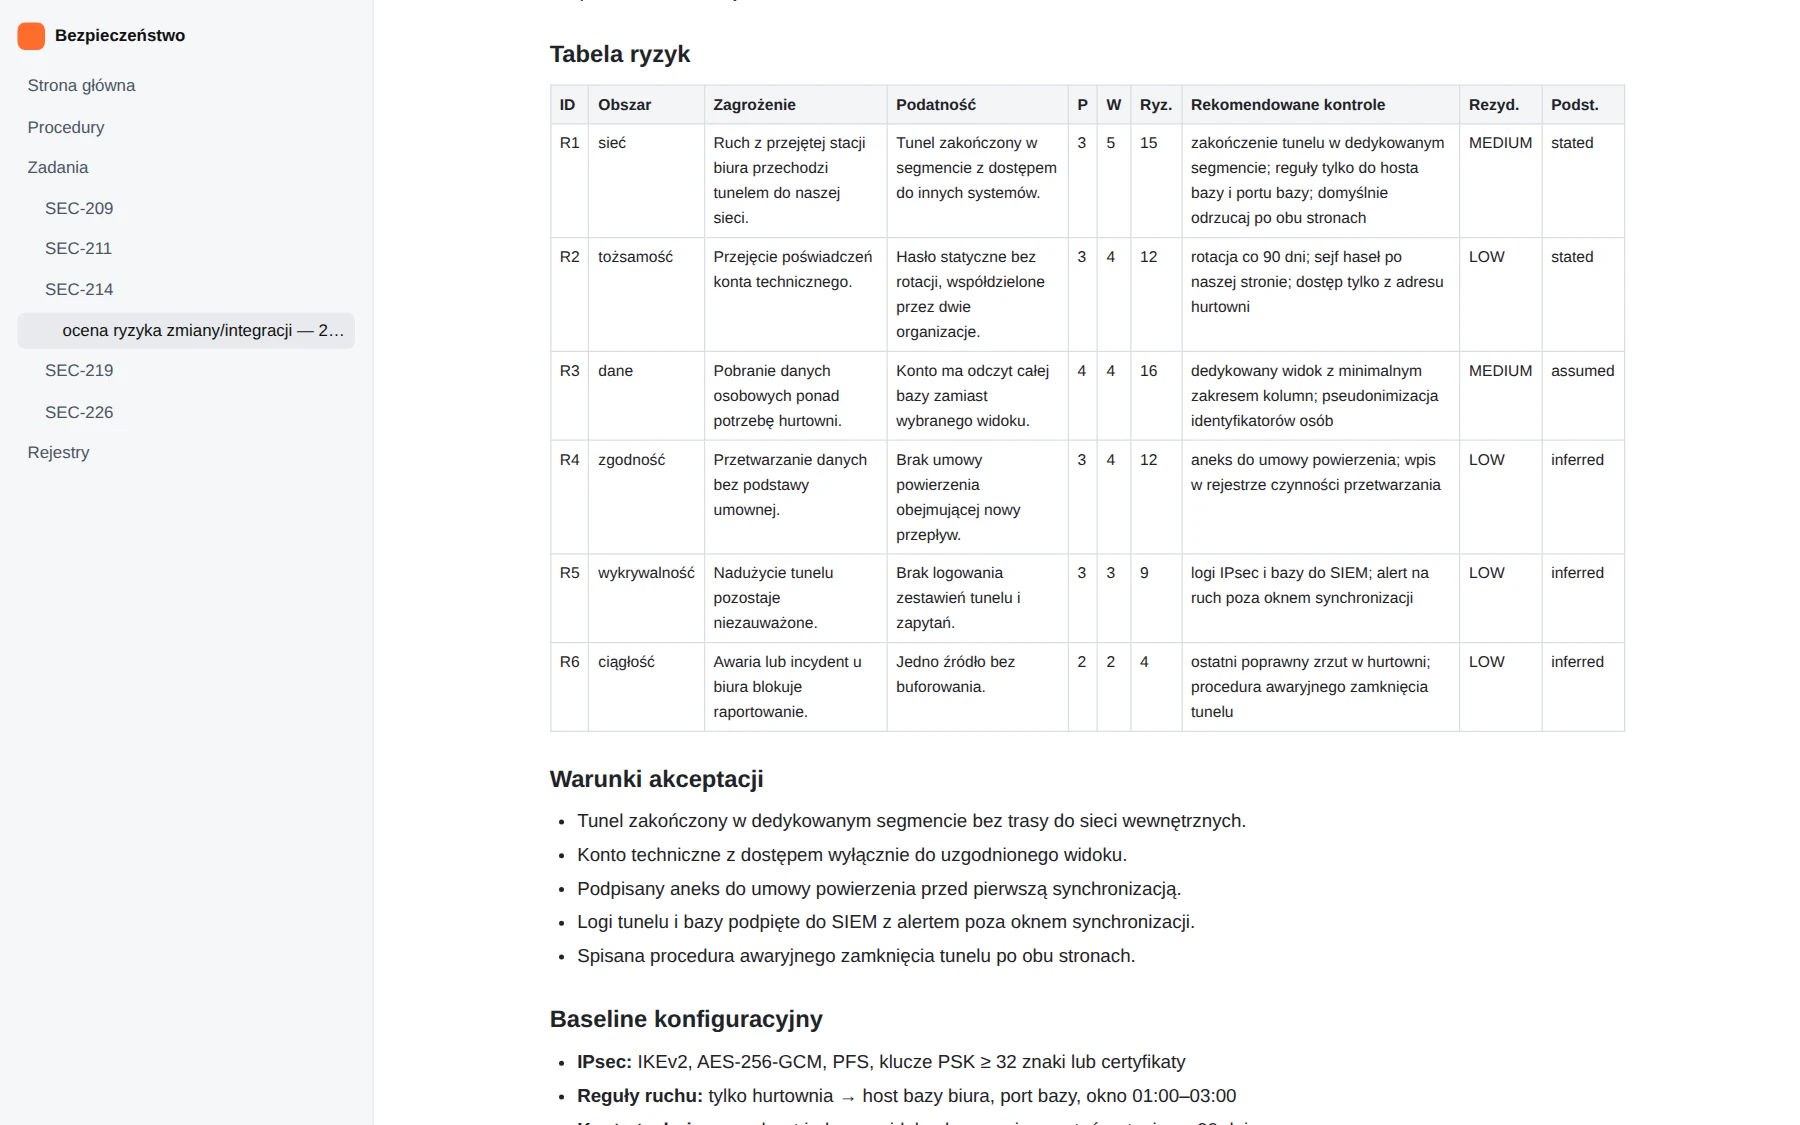
Własne wdrożenie, zmiana w infrastrukturze, integracja z partnerem. Produkt: tabela ryzyk, warunki akceptacji i rekomendacja eskalacji, gotowe do obrony przed audytorem.
Procedura, polityka, katalog, kontrolka SDLC albo opinia o przysłanym dokumencie. Pięć zadań programu SDLC nie uzasadniało osobnego agenta, więc działają jako tryb.
Największe skupisko, 34% korpusu: konfiguracje, inwentaryzacje, weryfikacje w panelach i treść załączników. Tu triage daje listę kontrolną i jawnie mówi, że AI nic więcej nie wniesie.
04 / architektura
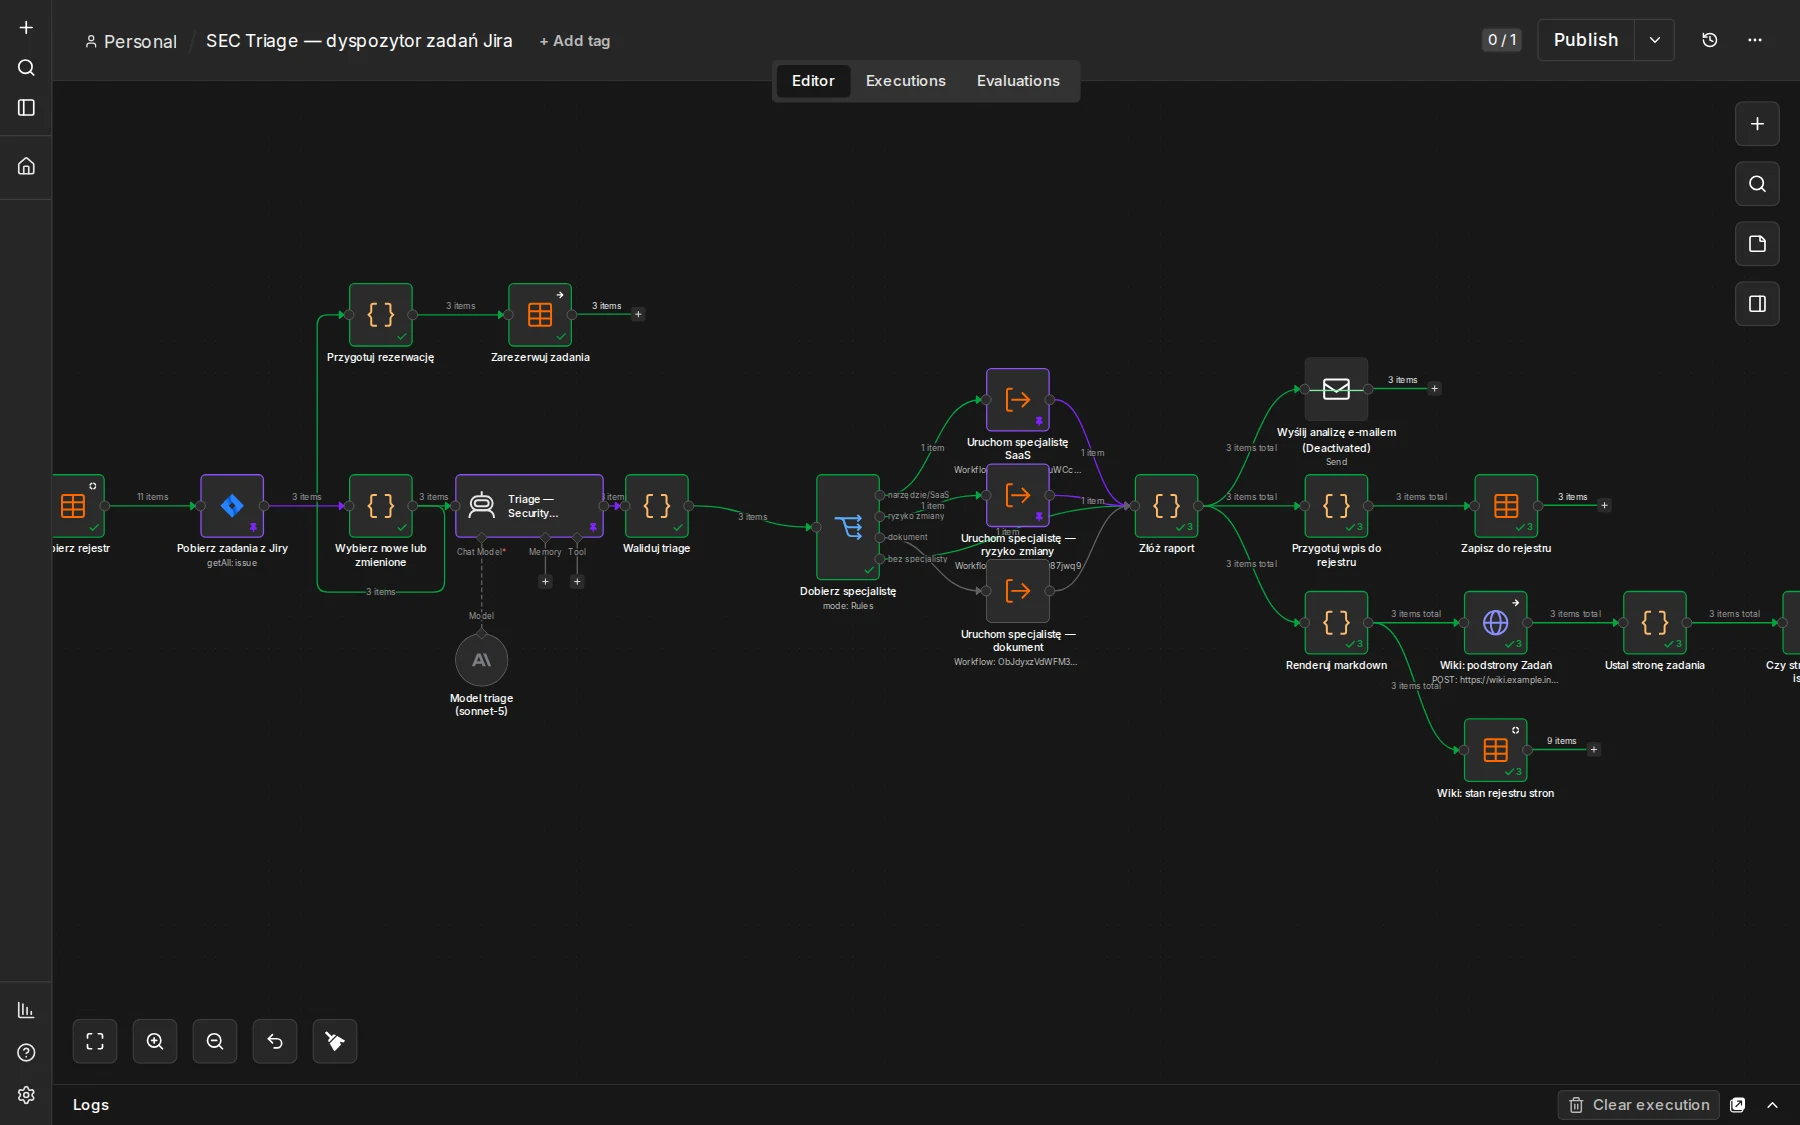
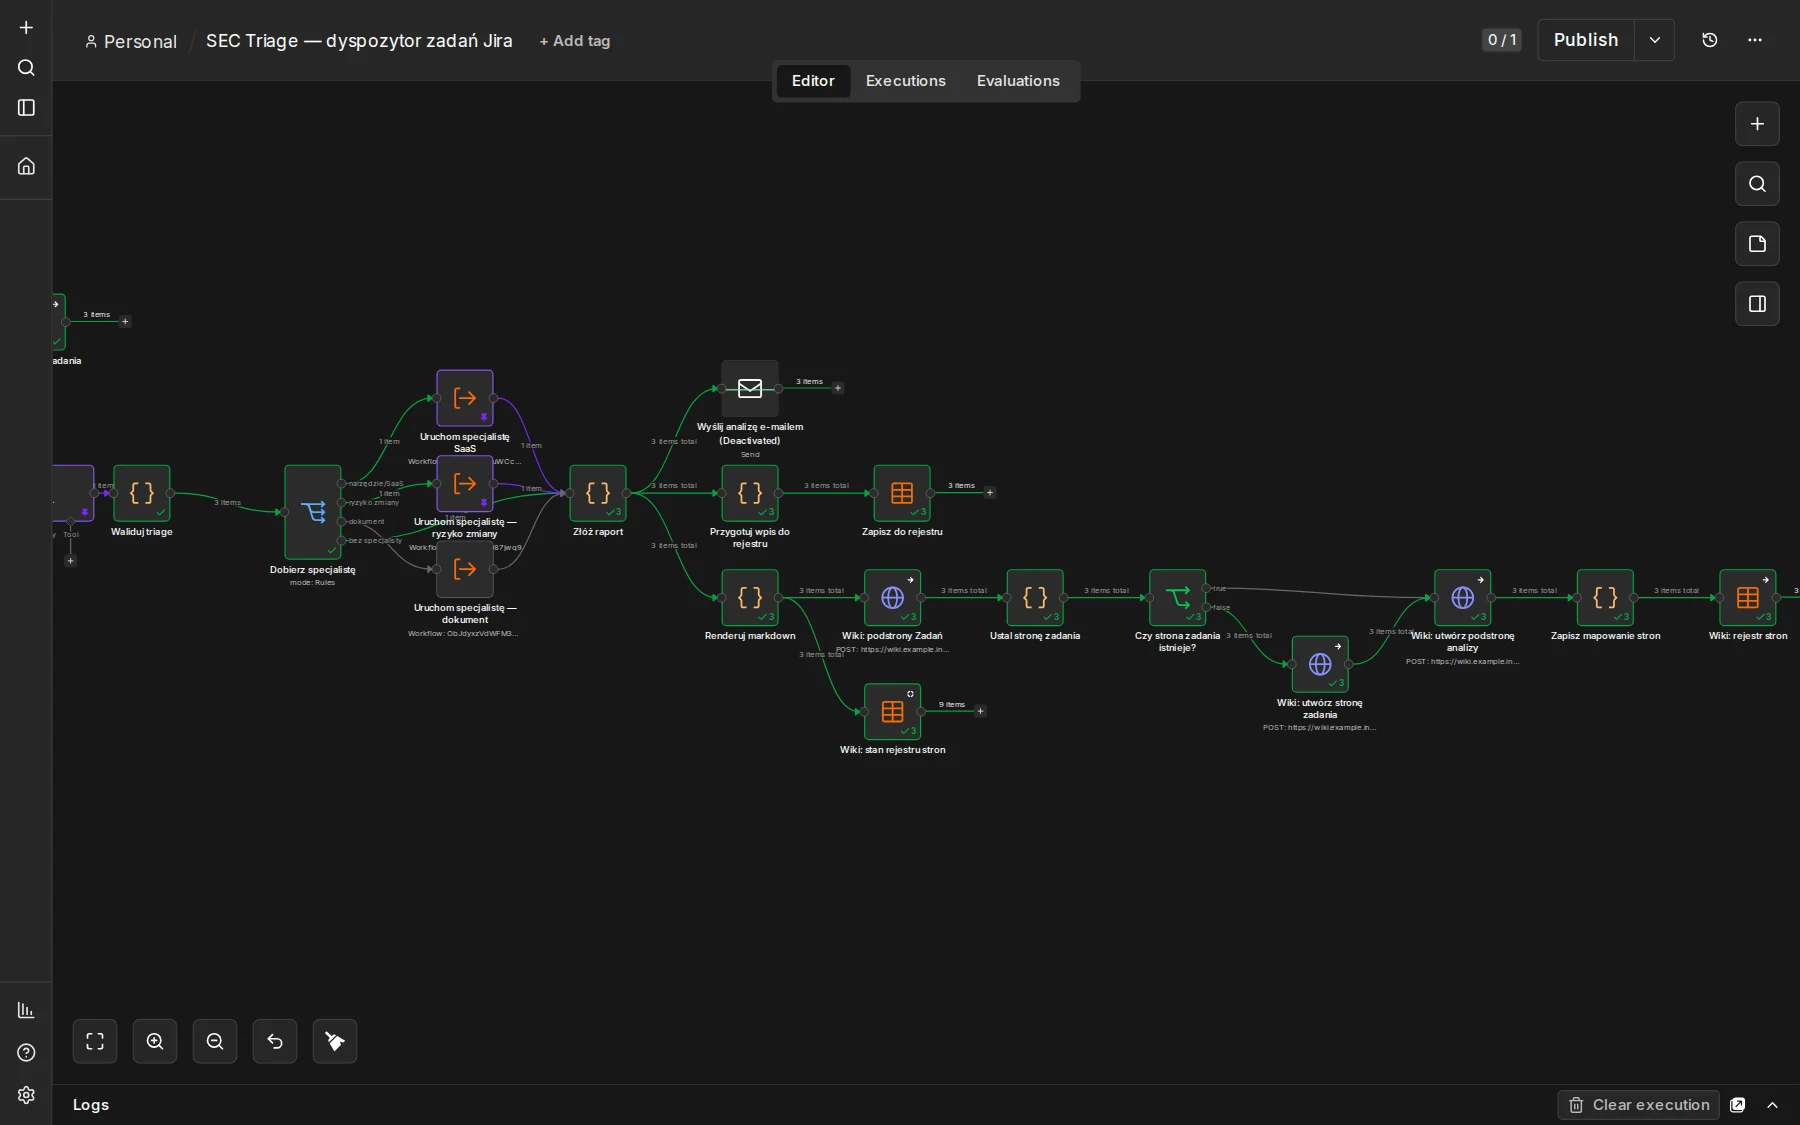
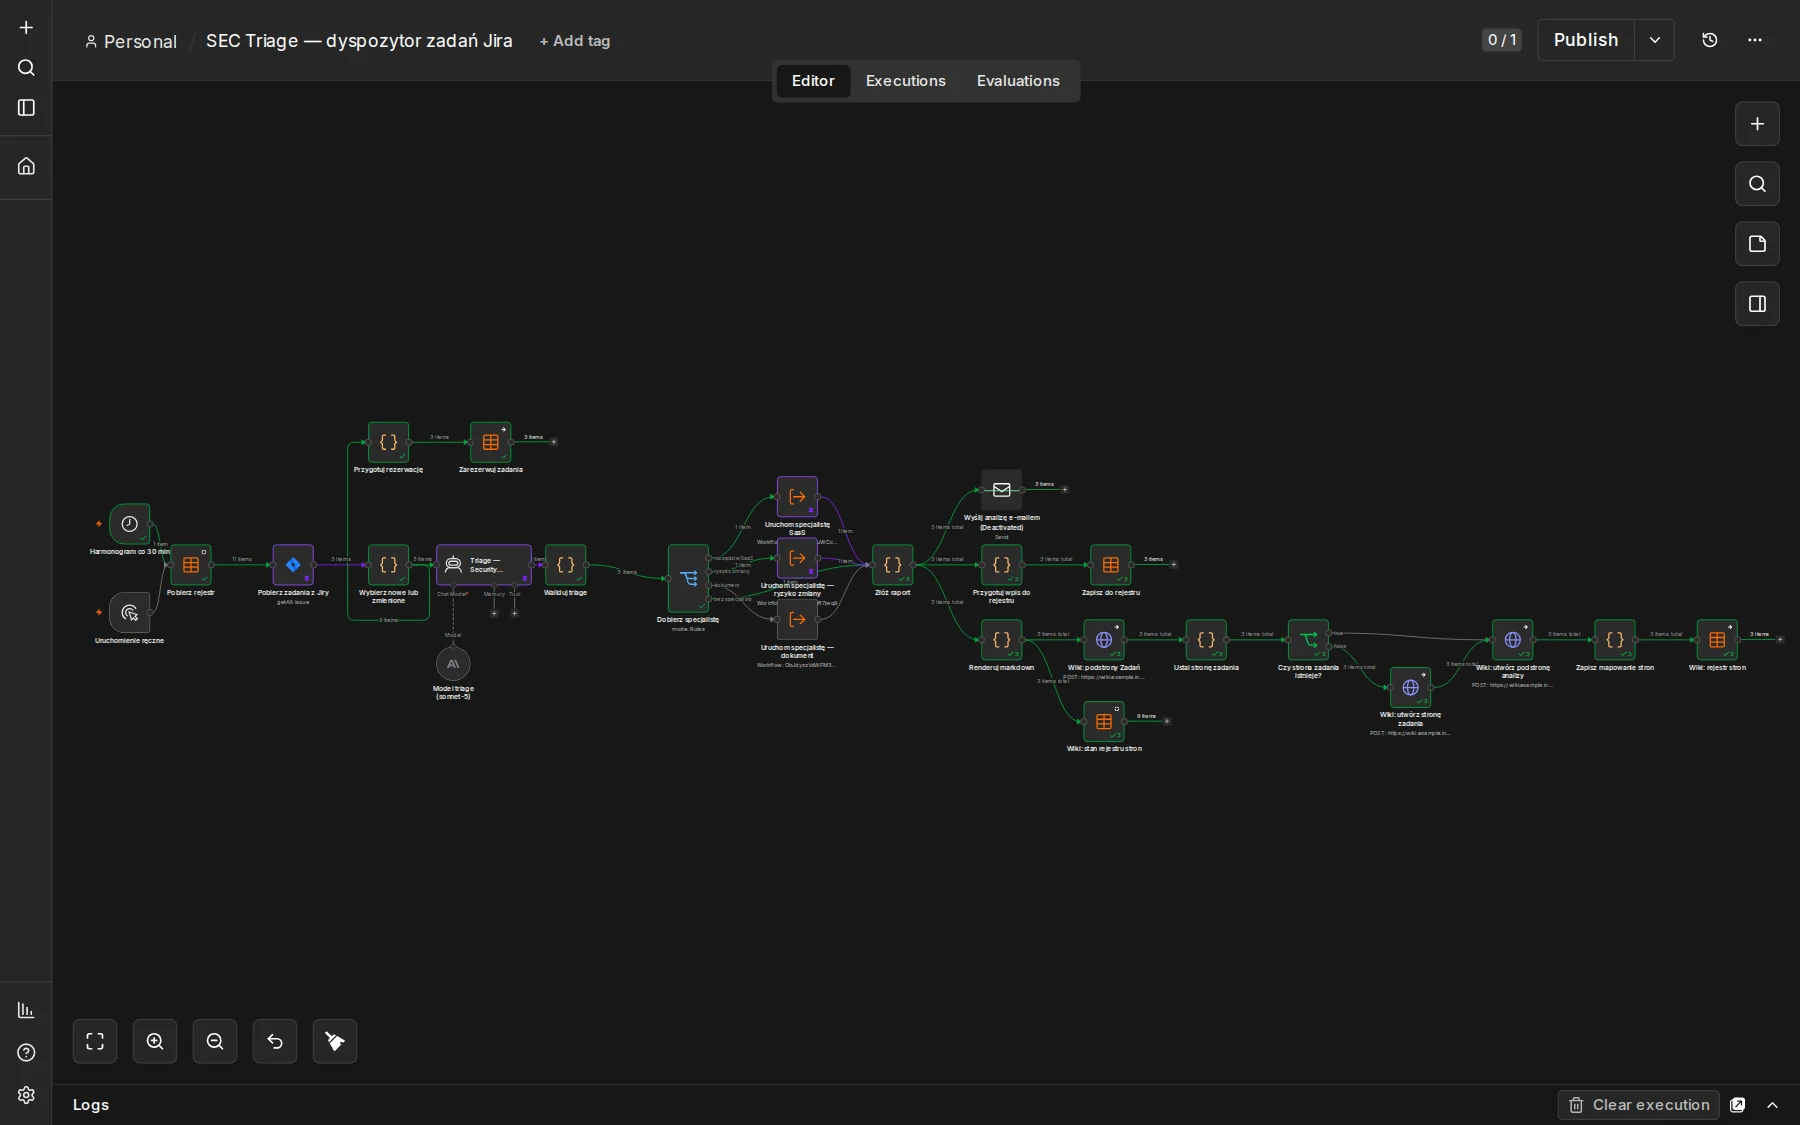
Dyspozytor ma 27 węzłów. Specjaliści to osobne podworkflowy wywoływane synchronicznie, więc każdy da się rozwijać i testować niezależnie, a raport składa się w jednym miejscu.
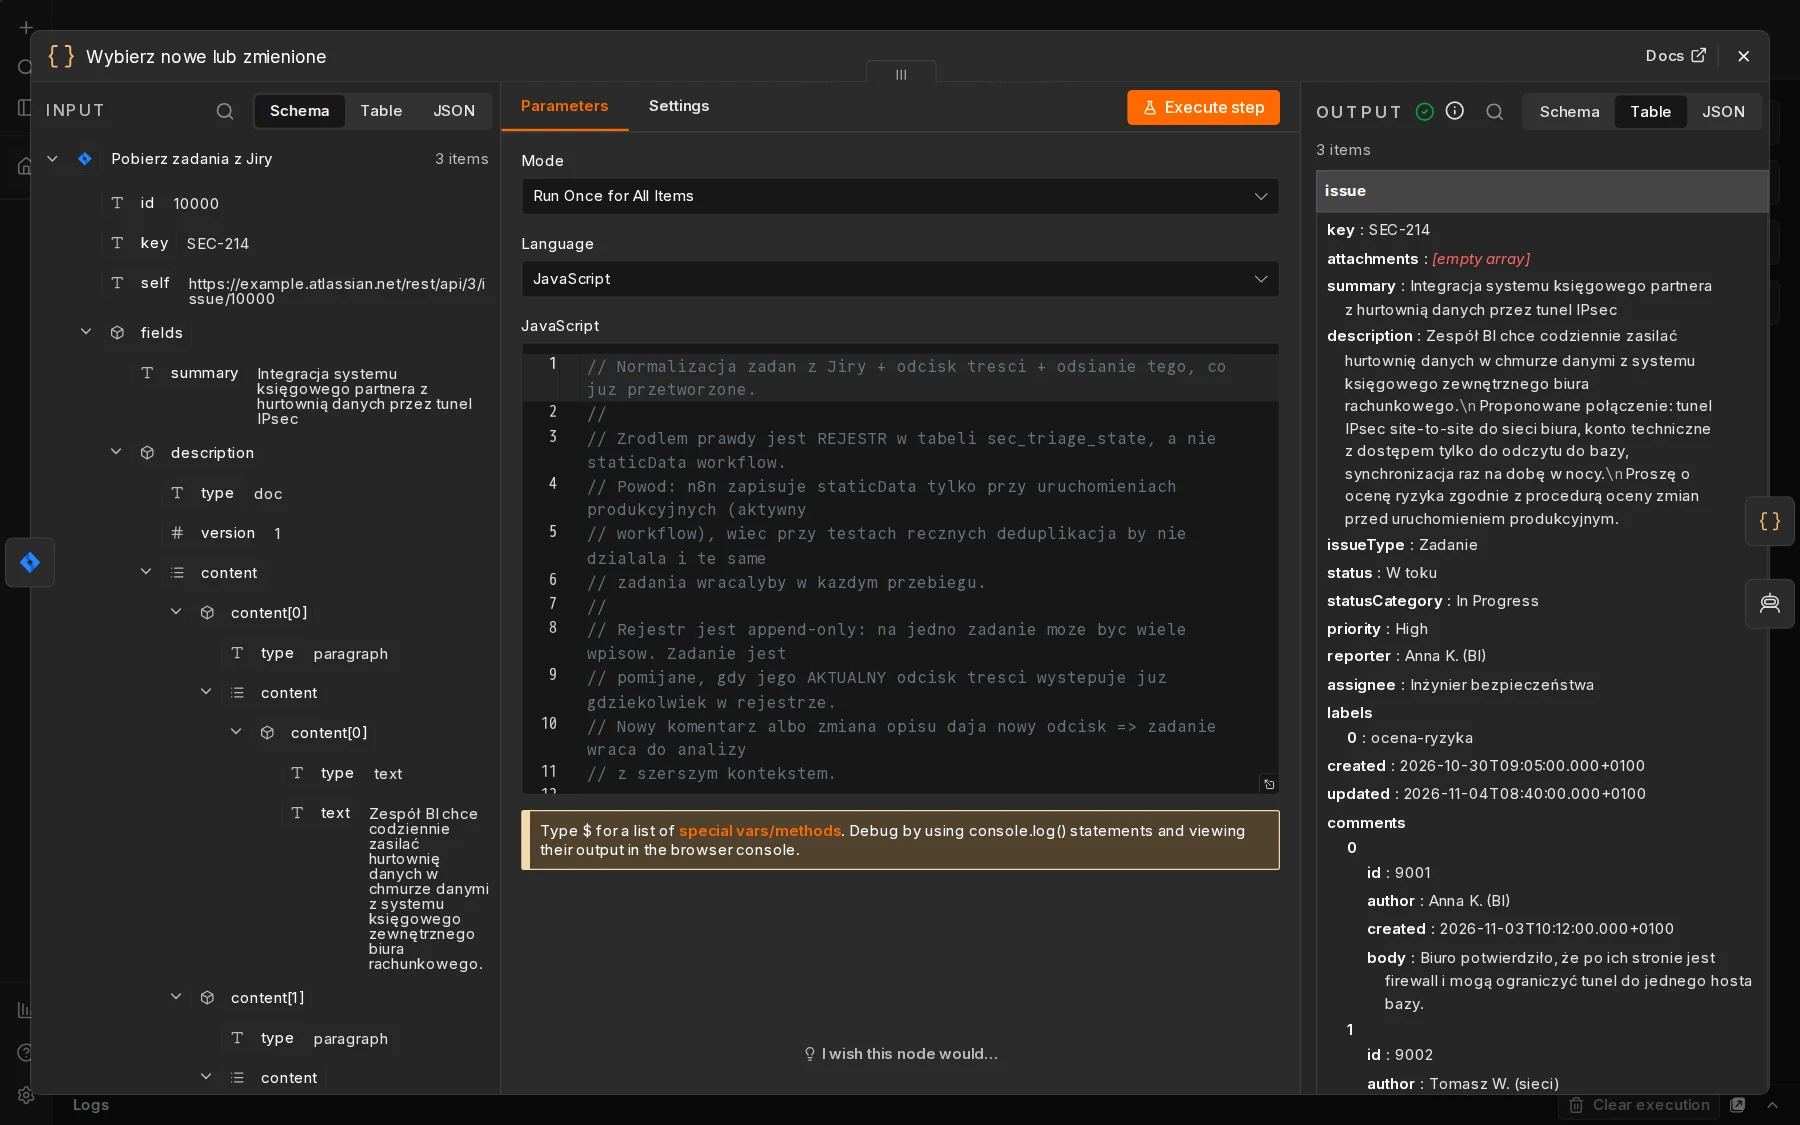
To, czy uruchomić specjalistę, wylicza kod walidacji: model musi zadeklarować realny wkład (pełny produkt albo szkic) i wskazać jednego z trzech znanych agentów. Przełącznik w n8n tylko kieruje, więc logiki nie trzeba szukać po węzłach.
Triage robi tańszy Claude Sonnet, bo widzi każde zadanie. Specjaliści pracują na Claude Opus, bo ich produkt trafia do dokumentacji. Model triage nie musi być najlepszy, ma być dobrze skalibrowany.
Specjalista dostaje pełny kontekst: opis, wszystkie komentarze, metadane załączników i ustalenia z triage. Nie wymagamy kompletnego zgłoszenia, bo analiza korpusu pokazała, że prawie żadne takie nie jest. Luki agent oznacza w produkcie.
05 / triage
Triage zwraca JSON według schematu. Większość pracy nad promptem poszła w kalibrację: modele lubią ustawiać średnie ryzyko z ostrożności i oznaczać każde zgłoszenie jako niekompletne.
Każdy poziom ma definicję: LOW to skutek lokalny i odwracalny, HIGH to dane osobowe, dostęp uprzywilejowany albo ekspozycja na zewnątrz. Średnie ryzyko musi wynikać z treści, nie z niepewności.
Jeśli wiadomo, jaki jest pierwszy krok, pole ma wartość true, a braki trafiają do osobnej listy. Fałsz zostaje dla sytuacji, w której bez odpowiedzi nie da się ruszyć.
Pytanie nie brzmi „czy AI domknie zadanie”, tylko „jaki użyteczny artefakt powstanie”. Odpowiedź „none” jest pełnoprawna i częsta. Ogólnik o ważności bezpieczeństwa jest gorszy niż jej brak.
Model dostaje tylko metadane plików. Nie może twierdzić, że załącznika nie ma: ma napisać, że plik wymaga przejrzenia przez człowieka i czego w nim szukać.
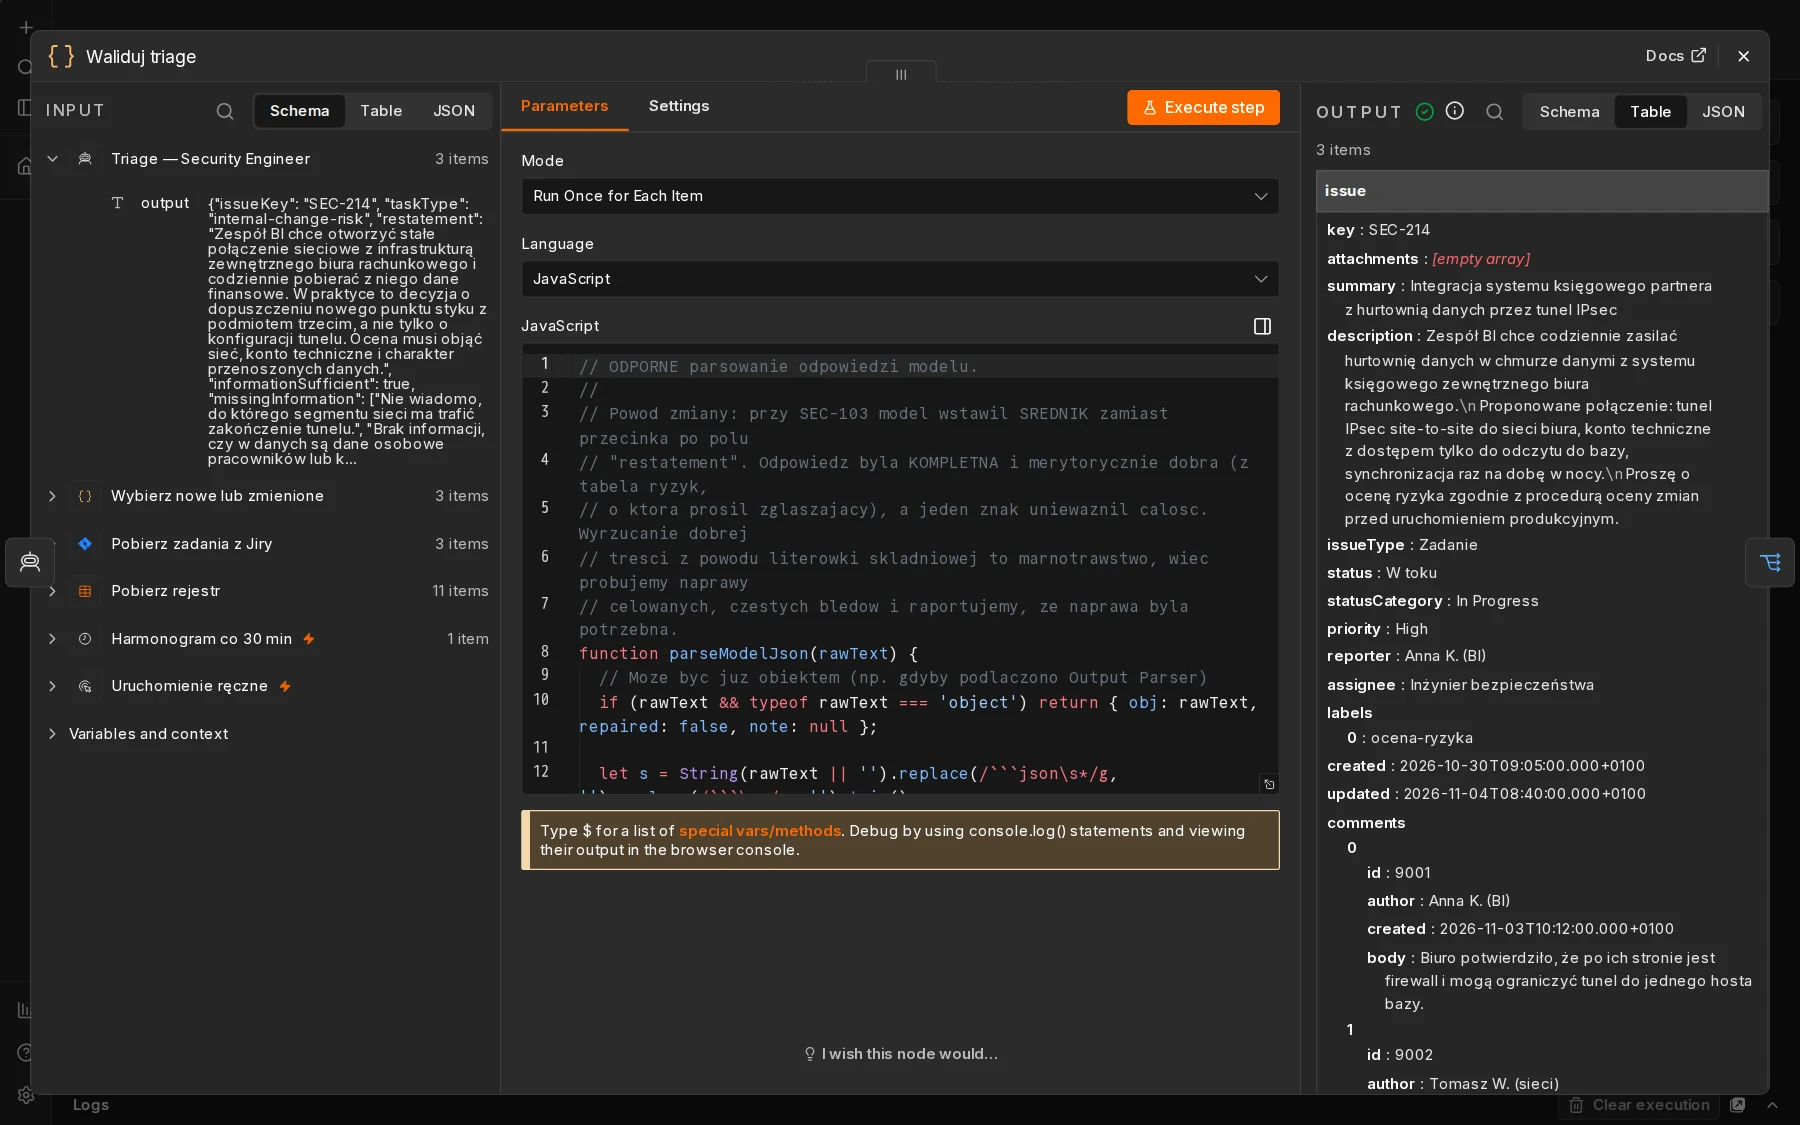
route, na którym działa przełącznik.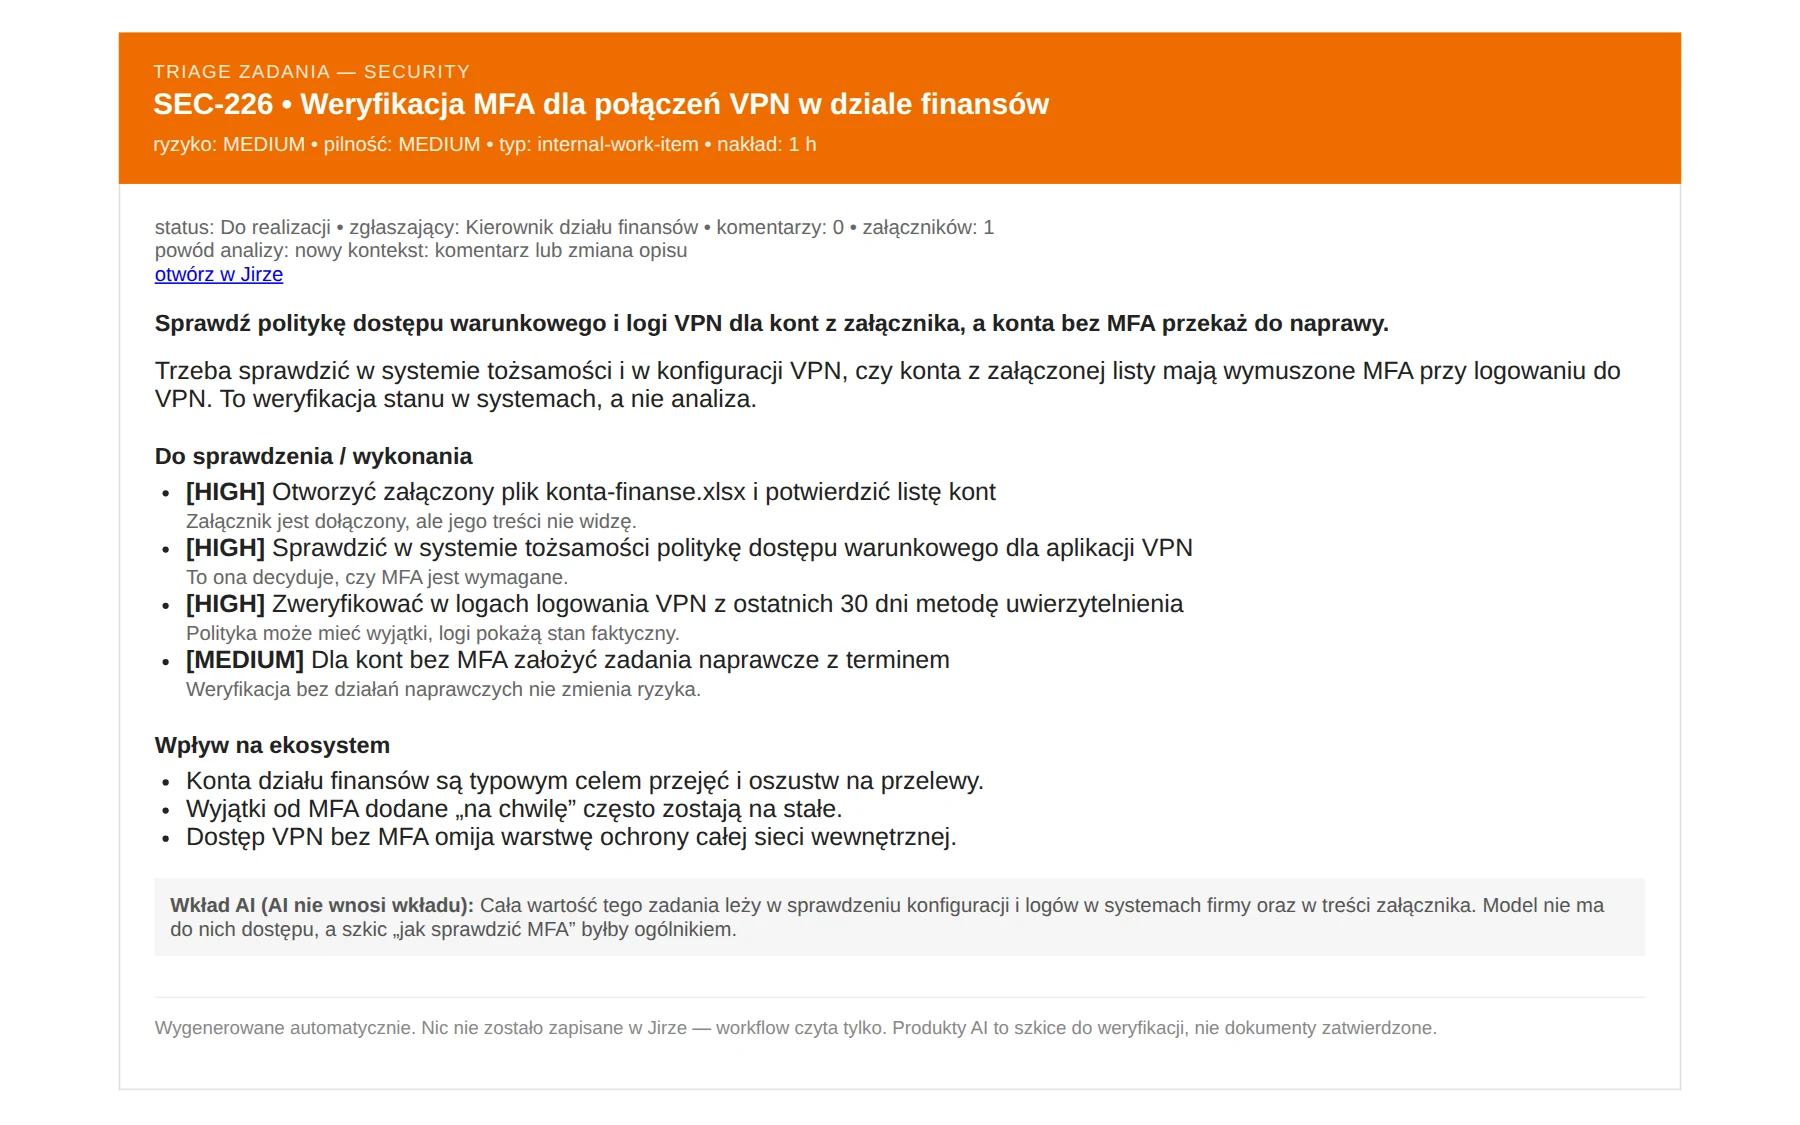
Raz model wstawił średnik zamiast przecinka w kompletnej, dobrej odpowiedzi z tabelą ryzyk. Parser próbuje teraz kilku celowanych napraw i zaznacza w raporcie, że naprawa była potrzebna. W 50 wpisach rejestru przydała się dwa razy.
Gdy odpowiedzi nie da się naprawić, raport mówi o awarii, a nie udaje oceny. Rejestr dostaje pusty odcisk treści, więc zadanie wraca do analizy przy następnym przebiegu, zamiast utknąć jako „przetworzone”.
06 / specjaliści
Wspólna zasada wszystkich agentów: odróżniać to, co wynika ze zgłoszenia, od tego, co jest wnioskiem albo założeniem. Ocena oparta na założeniu, o którym nikt nie wie, jest bezwartościowa.
07 / niezawodność
Workflow, który działa raz na pokazie, i workflow, który miesiącami co 30 minut nie wysyła duplikatów, to dwie różne rzeczy. Każdy wiersz poniżej to błąd złapany na prawdziwych przebiegach.
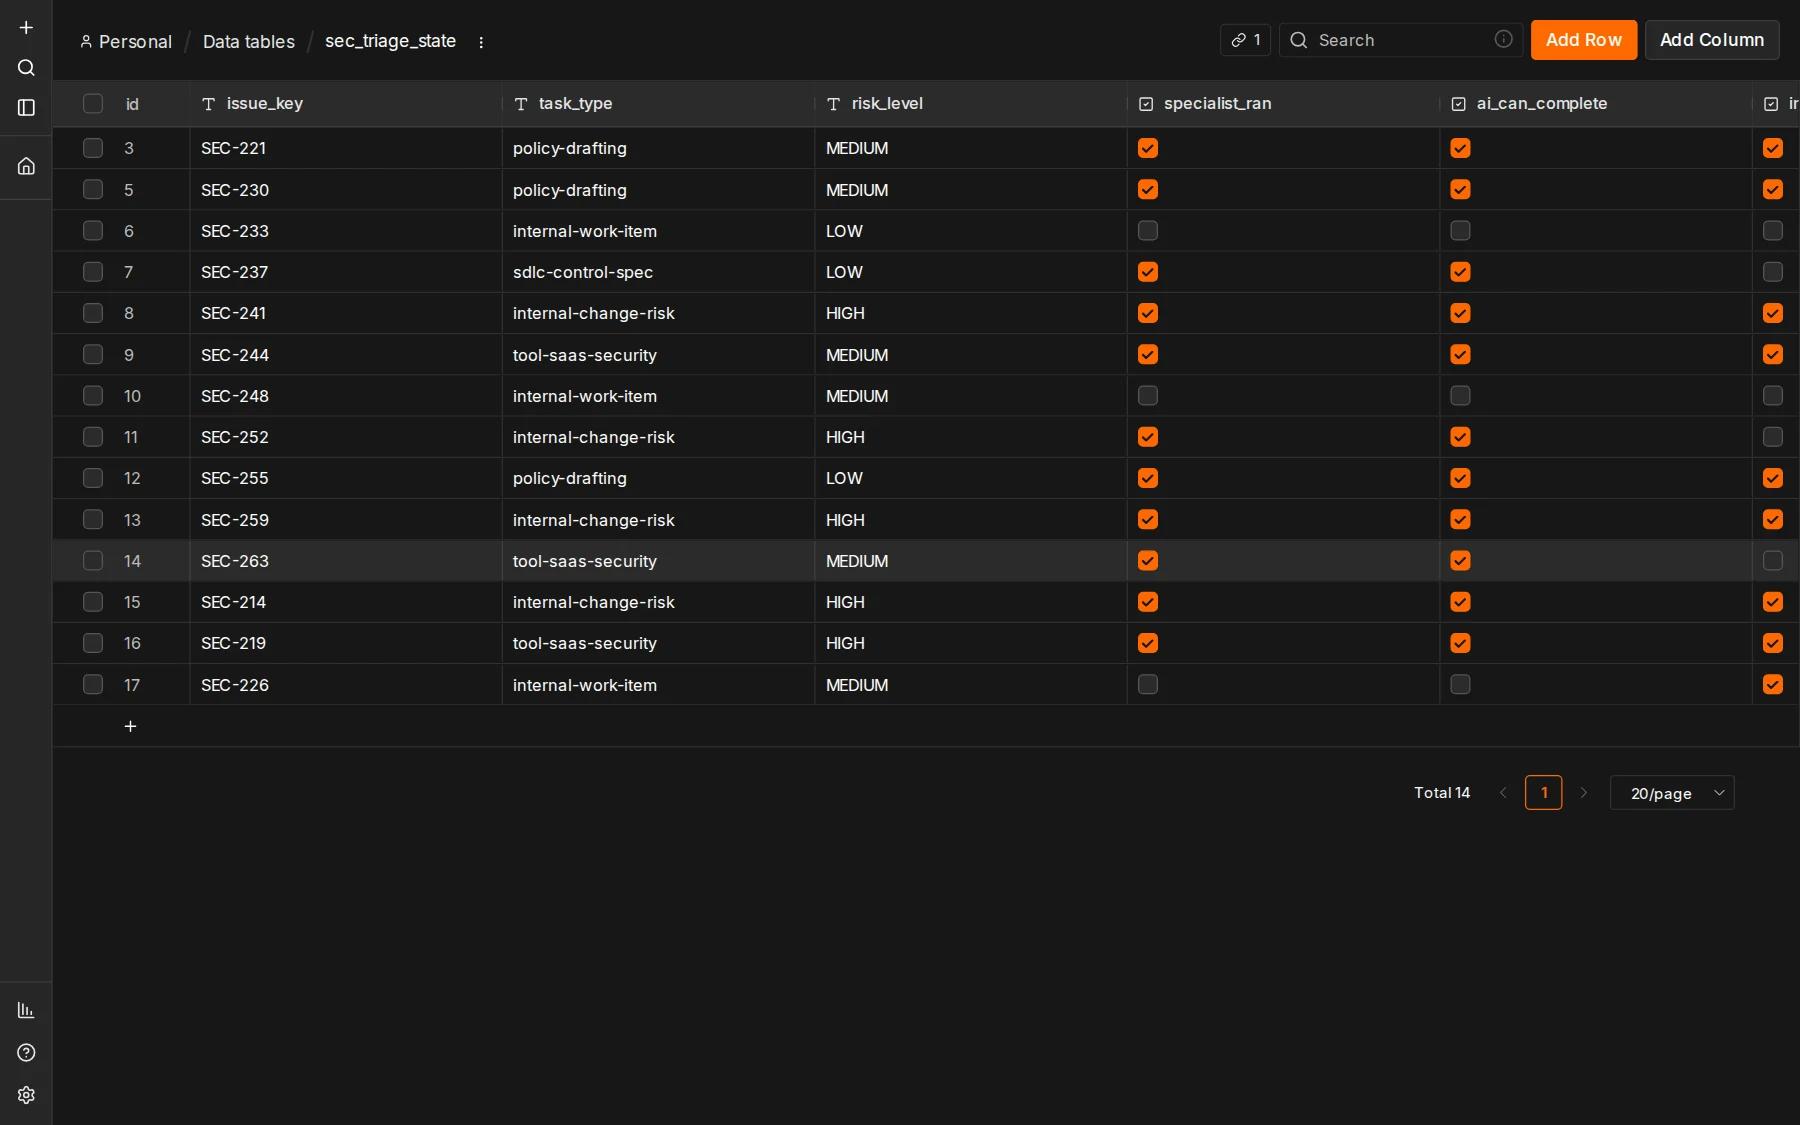
Pamięć statyczna n8n zapisuje się tylko przy uruchomieniach produkcyjnych, więc przy testach ręcznych te same zadania wracały w każdym przebiegu. Źródłem prawdy jest tabela danych z odciskiem treści: nowy komentarz albo załącznik zmienia odcisk i zadanie wraca do analizy.
Wynik zapisuje się na końcu, a analiza trwa kilka minut. Harmonogram i ręczne uruchomienie 36 sekund później dały dwie identyczne strony w wiki. Teraz zadanie jest rezerwowane w chwili wyboru, a rezerwacja wygasa, gdy przebieg padnie.
n8n w wersji community nie blokuje równoległych przebiegów. Triage trwa około 60 s, specjalista do 350 s, więc trzy zadania to w najgorszym razie około 21 minut. Stąd limit 3 zadań i cykl 30 minut: przebieg kończy się przed następnym.
| Objaw | Przyczyna | Rozwiązanie |
|---|---|---|
| 50 wierszy w rejestrze na 21 zadań | Domyślna operacja wstawiania ignoruje ustawione kolumny dopasowania. | Jawny upsert po kluczu zadania we wszystkich trzech tabelach. |
| Druga strona nadrzędna tego samego zadania w wiki | API wiki zwraca listę stron po 20 pozycji, a kontrola istnienia czytała tylko pierwszą. | Własny rejestr stron jako źródło prawdy i jawny sygnał ryzyka duplikatu zamiast cichego tworzenia. |
| Trzy zadania zlały się w jedno | Węzeł brał pierwszy element wejścia zamiast elementu sparowanego. | Tryb „raz na element” i odwołania do sparowanego elementu w każdym podworkflow. |
| Agent tracił zapytania z budżetu | Wywołanie narzędzia bez argumentów kończyło się cichą pustą odpowiedzią albo błędem walidacji schematu. | Narzędzie bez schematu wejścia, walidacja w podworkflow i komunikat naprawczy dla modelu. |
| 76 tys. z 82 tys. tokenów to wyniki wyszukiwania | Surowe odpowiedzi po 8–21 kB narastały w kontekście agenta przy każdej turze. | Skracanie wyników do fragmentów z limitem 8 tys. znaków na odpowiedź. |
| Raport twierdził, że załącznika nie ma | Model nie dostawał listy plików, więc ich brak brał za fakt. | Metadane załączników w prompcie, zakaz zaprzeczania ich istnieniu, odcisk treści obejmuje pliki. |
08 / wynik
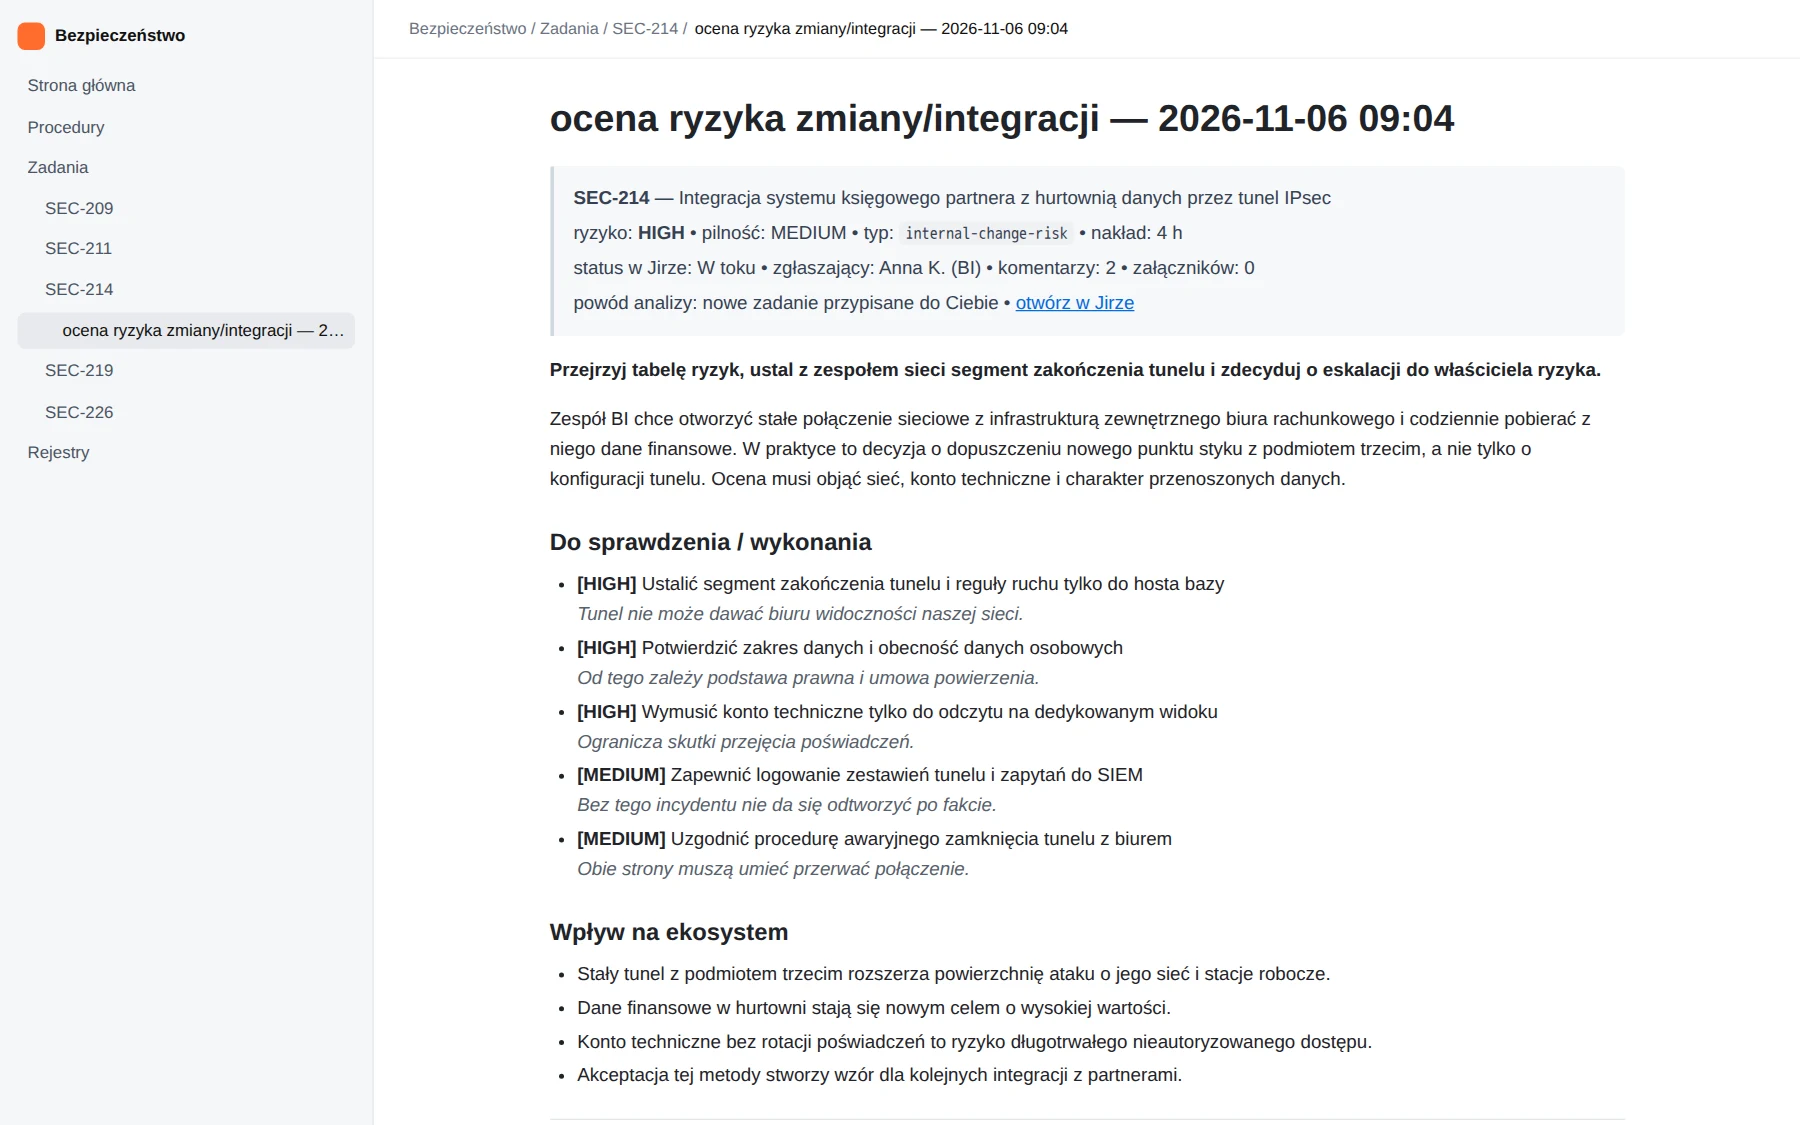
Pierwsza wersja wysyłała tylko e-mail. Dziś każde zadanie ma w wiki stronę nadrzędną, a każda analiza trafia na nią jako podstrona z datą. Nowy komentarz w Jirze to nowa podstrona, więc widać, jak zmieniała się ocena. E-mail został jako opcja: węzeł jest wyłączony, odkąd archiwum przejęło wiki.
09 / wdrożenie
Pierwsza wersja: pobranie zadań, triage jednym modelem i raport HTML w skrzynce. Już ona pokazała, które pola modelu są szumem, a które pomagają.
Jednorazowy workflow pobrał wszystkie zadania, także zamknięte, bo pokazują pracę faktycznie wykonaną. Model pogrupował je według rodzaju pracy i wskazał, gdzie AI nic nie wniesie.
Trzy podworkflowy z własnymi promptami i schematami odpowiedzi. Specjalista od narzędzi dostał później wyszukiwanie w internecie, z budżetem zapytań i rozróżnieniem źródeł.
Strona zadania z podstronami analiz, rejestr stron i rejestr analiz. Rejestry służą jednocześnie do deduplikacji, audytu i statystyk.
Rezerwacje, upserty, paginacja, odporne parsowanie, limity długości odpowiedzi. Poprawki mają w kodzie i notatkach węzłów opis objawu i przyczyny, często z numerem przebiegu, który je ujawnił.
technologie
Dane klienta są zanonimizowane. Zrzuty pochodzą z odizolowanej kopii workflow uruchomionej na danych przykładowych: zgłoszenia, osoby, odpowiedzi modeli i klucze zadań są fikcyjne, a adresy, identyfikatory i dane dostępowe zostały zastąpione. Raporty na zrzutach wygenerował prawdziwy kod workflow. Liczby w sekcji 02 pochodzą z produkcyjnego rejestru analiz (sierpień–listopad 2026). Produkty AI są szkicami do weryfikacji przez człowieka, nie zatwierdzonymi dokumentami.
następny krok
Opisz, co chcesz osiągnąć. Wrócę z konkretną propozycją, wyceną i planem wdrożenia.