Co wolno twierdzić
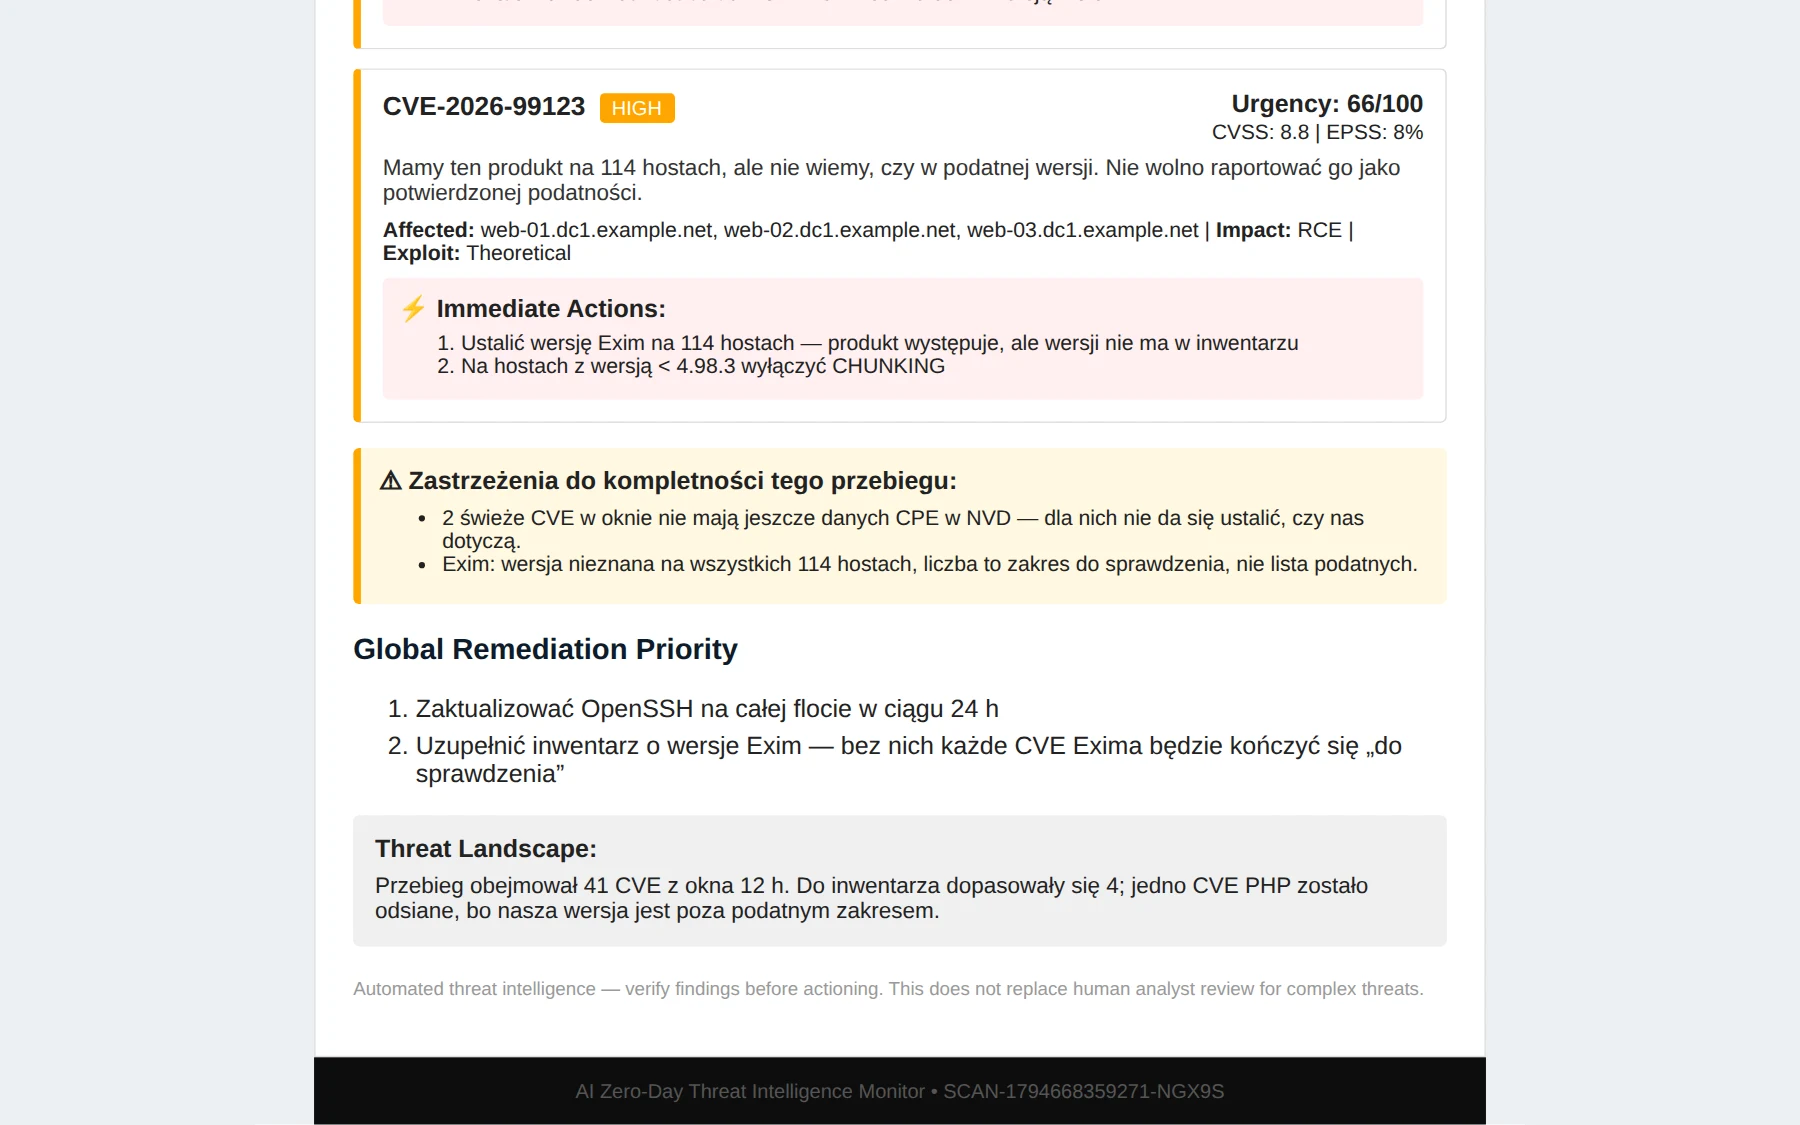
Przy cpe-product model nie może napisać „jesteśmy podatni”. Ma napisać, że produkt występuje i pierwszym krokiem jest ustalenie wersji na wskazanych hostach.
case study · monitoring podatności z AI w n8n
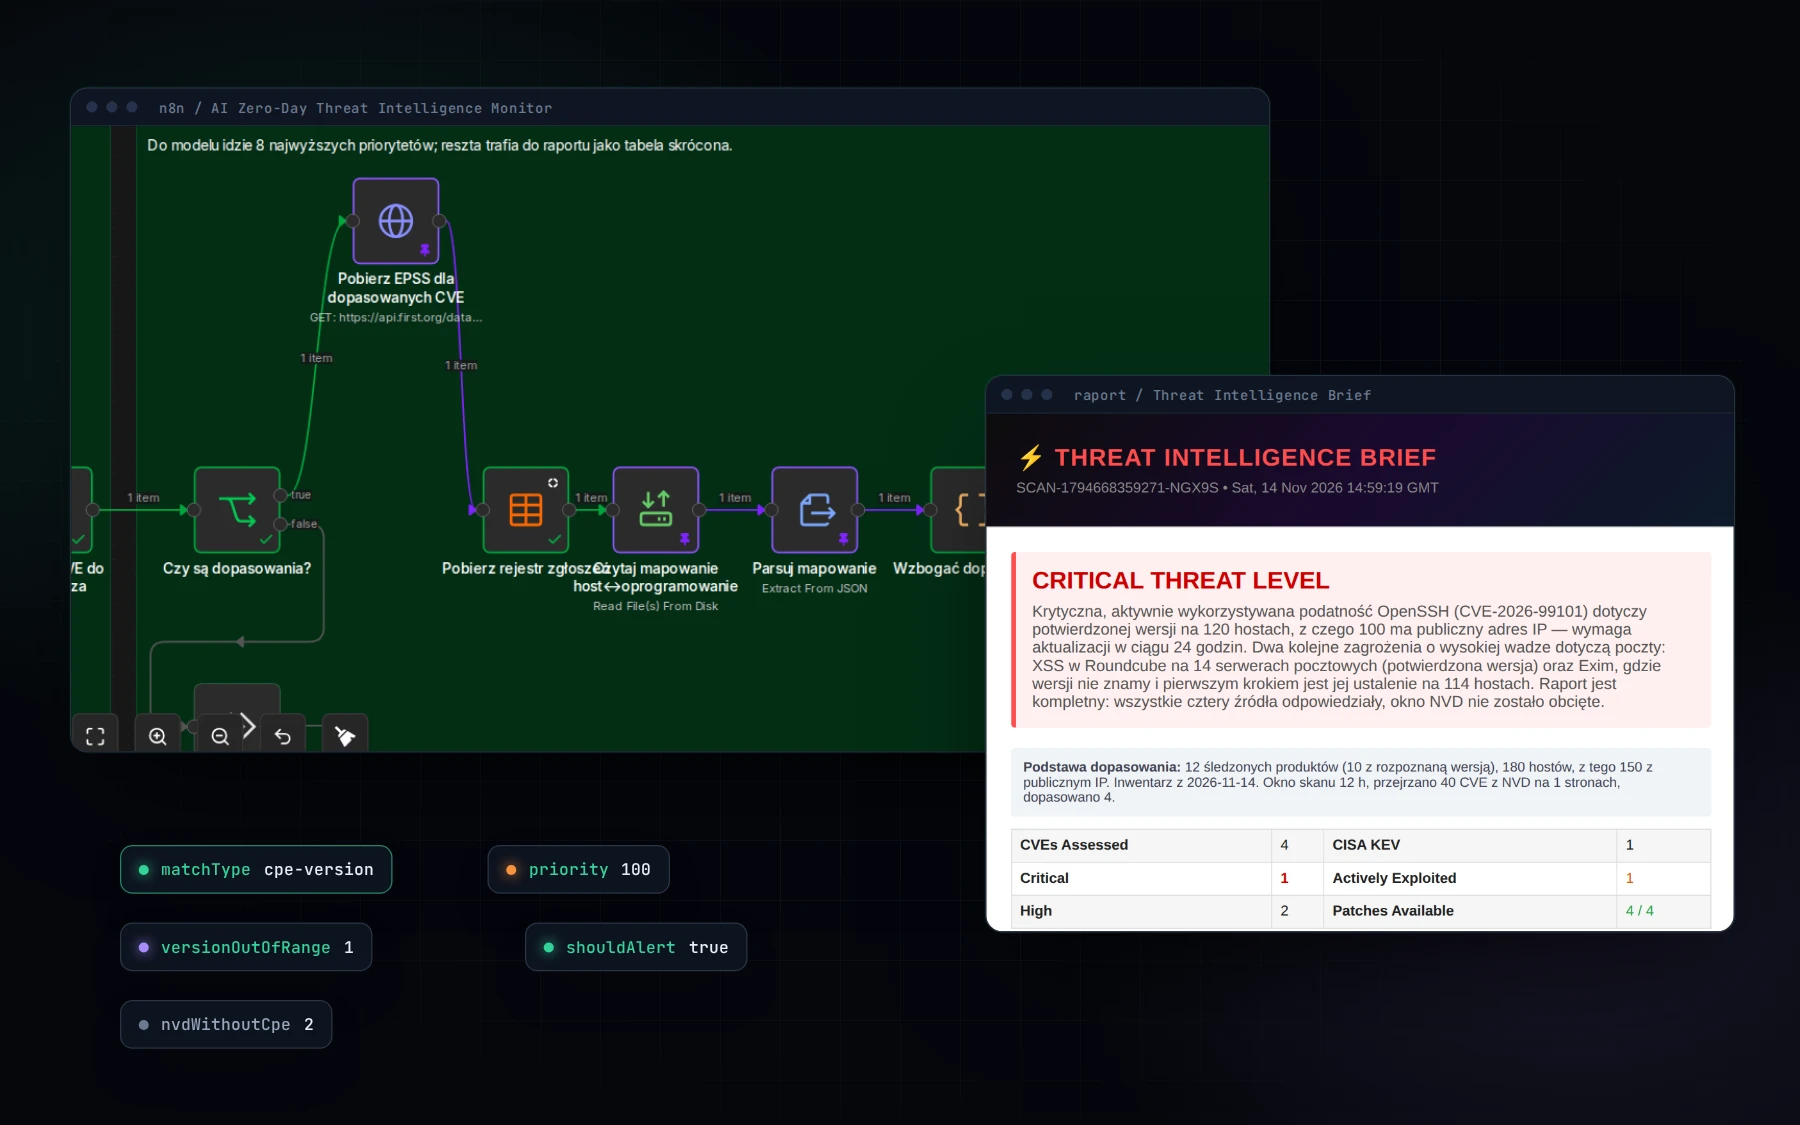
Workflow w n8n pobiera nowe CVE z czterech źródeł, przecina je lokalnie z inwentarzem kilku tysięcy serwerów i liczy priorytet z wagi podatności i skali ekspozycji. Model AI dostaje już dopasowane zagrożenia i ocenia je jak analityk. O tym, czy podatność nas dotyczy, decyduje kod, nie model.
01 / punkt wyjścia
Firma utrzymuje kilka tysięcy serwerów, w większości wystawionych do internetu: serwery WWW, poczta, bazy danych, DNS. Celem było dowiedzieć się o groźnej podatności, zanim pojawi się errata dystrybucji, i tylko wtedy, gdy rzeczywiście dotyczy naszej infrastruktury.
Okno 72 godzin w NVD to ponad 4,7 tys. rekordów. Ręczne sprawdzanie, które z nich dotyczą naszych maszyn, jest niewykonalne.
Gotowe narzędzia zalewają zespół zgłoszeniami. System, który alarmuje codziennie, przestaje być czytany.
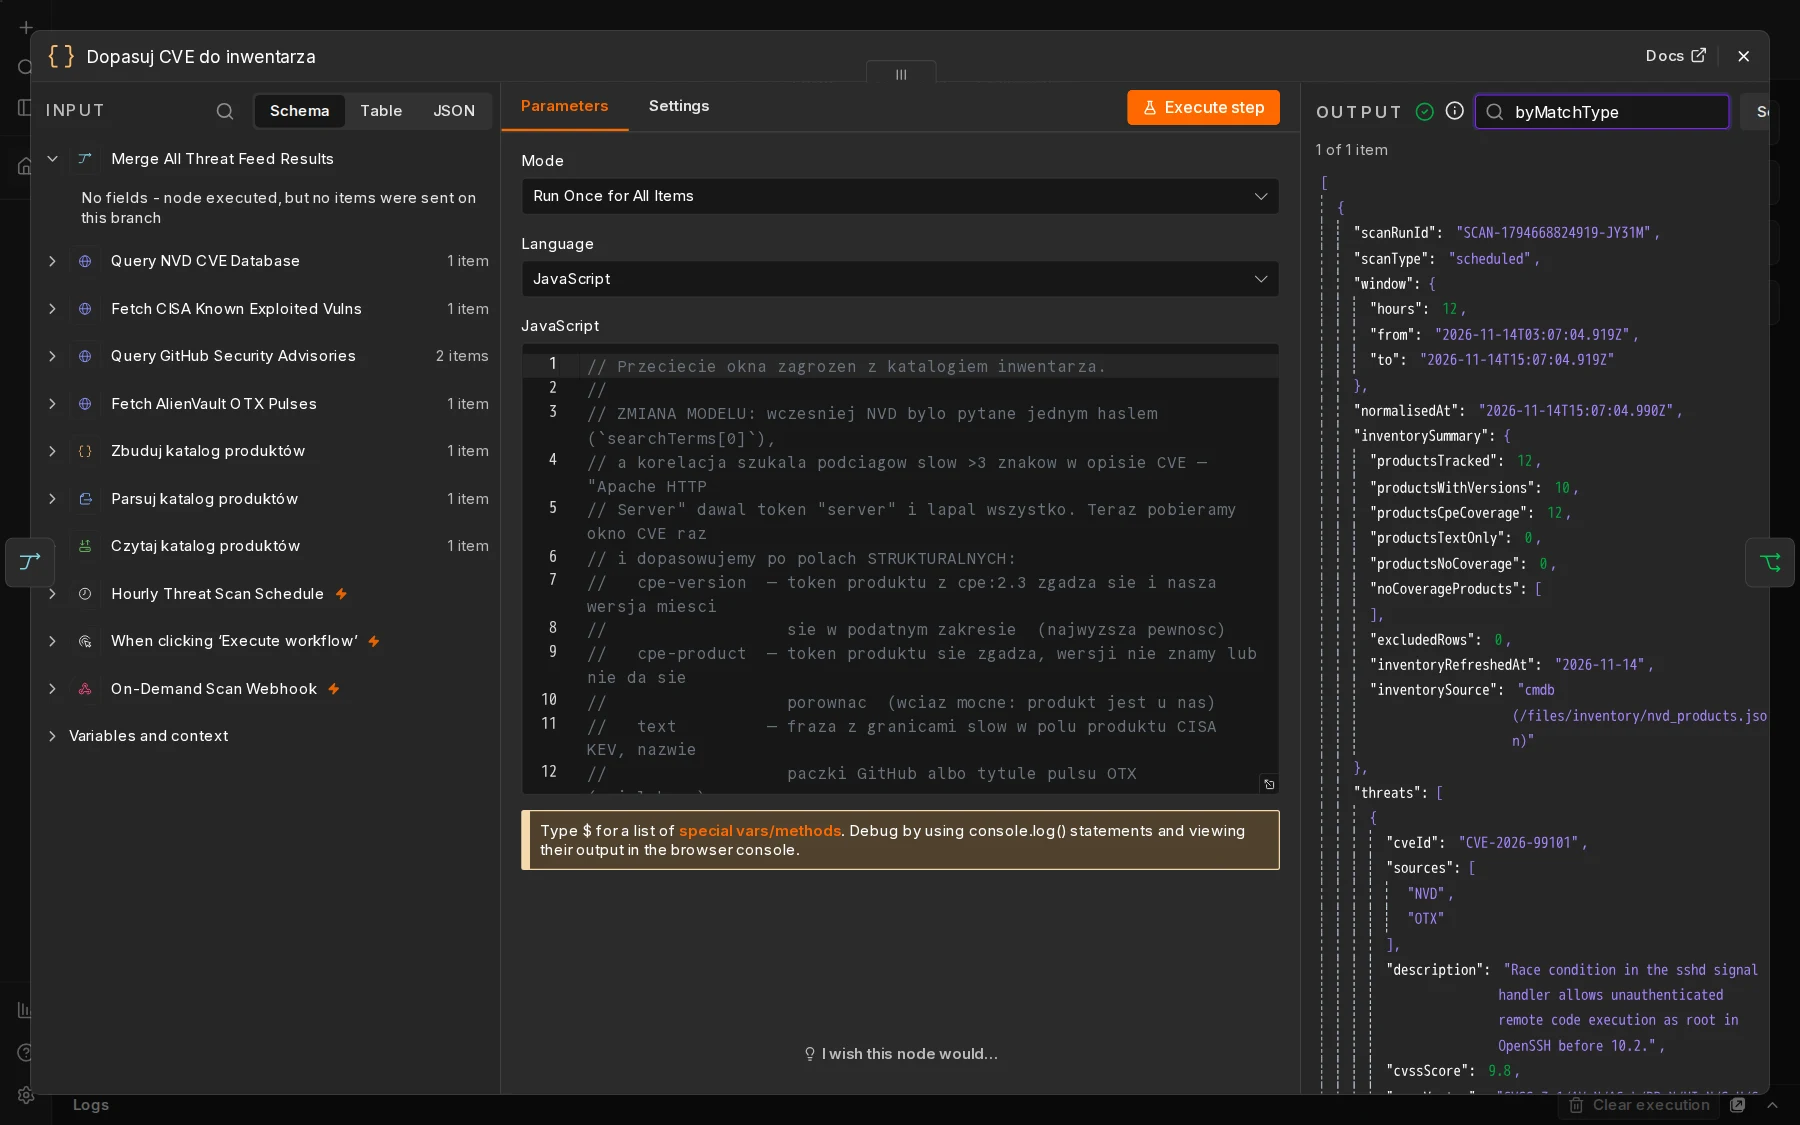
Workflow budował listę haseł, ucinał ją do 20 pozycji i wysyłał do NVD tylko pierwsze. Pokrycie było przypadkowe i niemierzalne.
„Apache HTTP Server” dawał token „server”, więc każde CVE ze słowem server trafiało w hosty z Apache.
Dystrybucje backportują poprawki bez zmiany numeru wersji. Porównanie samego numeru z zakresem w NVD daje fałszywe trafienia na masową skalę.
Podatność na jednej wewnętrznej maszynie dostawała tę samą ocenę co zdalne wykonanie kodu na setkach serwerów z publicznym IP.
02 / wskaźniki
Liczby z pomiarów na produkcyjnej instancji podczas przebudowy i z rejestru zgłoszeń (sierpień–październik 2026).
Przed przebudową dopasowanie przekraczało limit 300 s węzła Code i proces kończył się błędem, więc 300 s to dolna granica. Ostatni wiersz: zamiast jednego hasła workflow pobiera całe okno CVE i przecina je z pełnym katalogiem.
03 / architektura
Zamiast pytać źródła o każdy produkt osobno, workflow pobiera całe okno nowych i zmienionych CVE raz i przecina je z katalogiem w kodzie. Koszt API przestał zależeć od wielkości inwentarza, a pokrycie jest pełne i mierzalne.
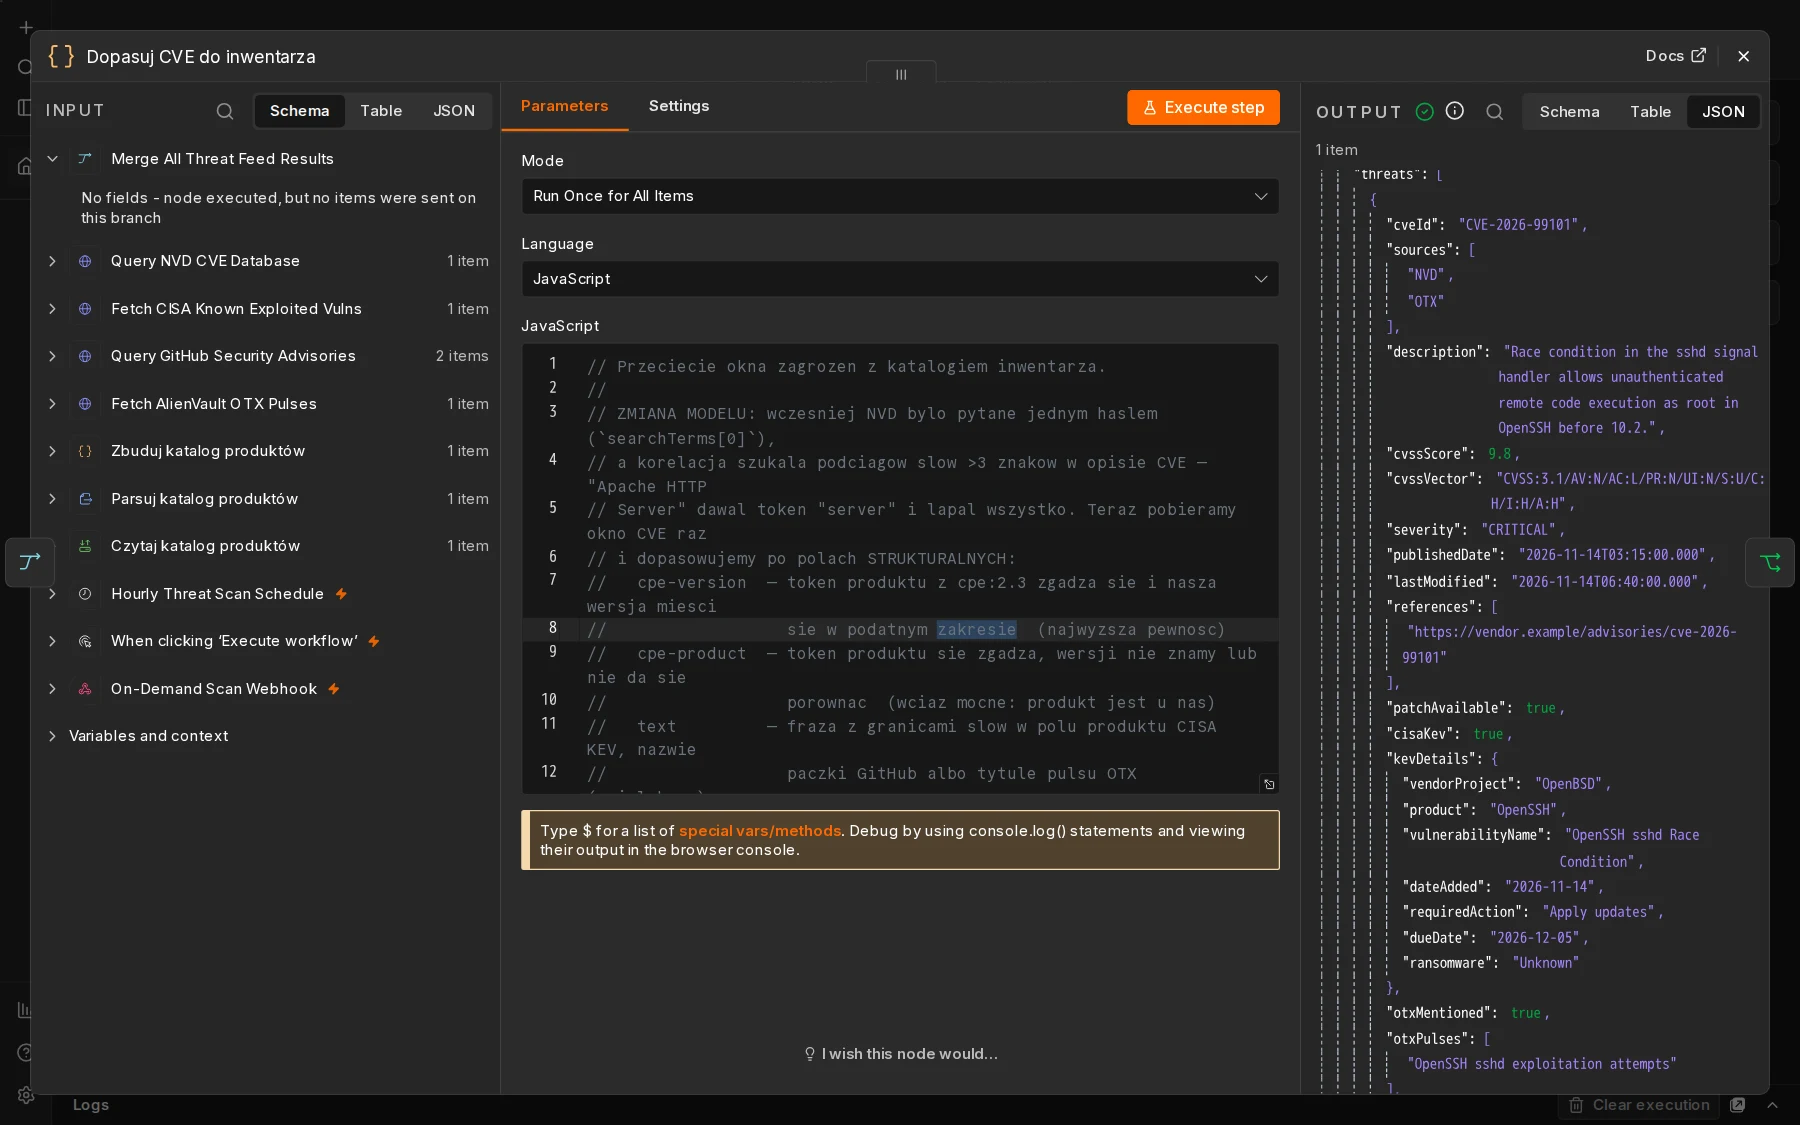
NVD pytane jest o lastMod, nie o datę publikacji. Dzięki temu łapie także starsze CVE, którym NVD dopiero teraz dopisał dane CPE. Paginacja po 2000 rekordów, a obcięte okno jest raportowane wprost.
Katalog KEV ma ponad 1,6 tys. pozycji, w większości o produktach, których nie mamy. Dlatego KEV i EPSS podnoszą wagę dopasowanego CVE, ale same nie wciągają niczego do raportu. Wyjątek: wpis dodany do KEV w oknie skanu.
http_server występuje w CPE jako apache:http_server i akka:http_server. Bez kwalifikacji każde CVE Akki trafiało we wszystkie hosty z Apache. Aliasy są kuratorowane dla całego katalogu.
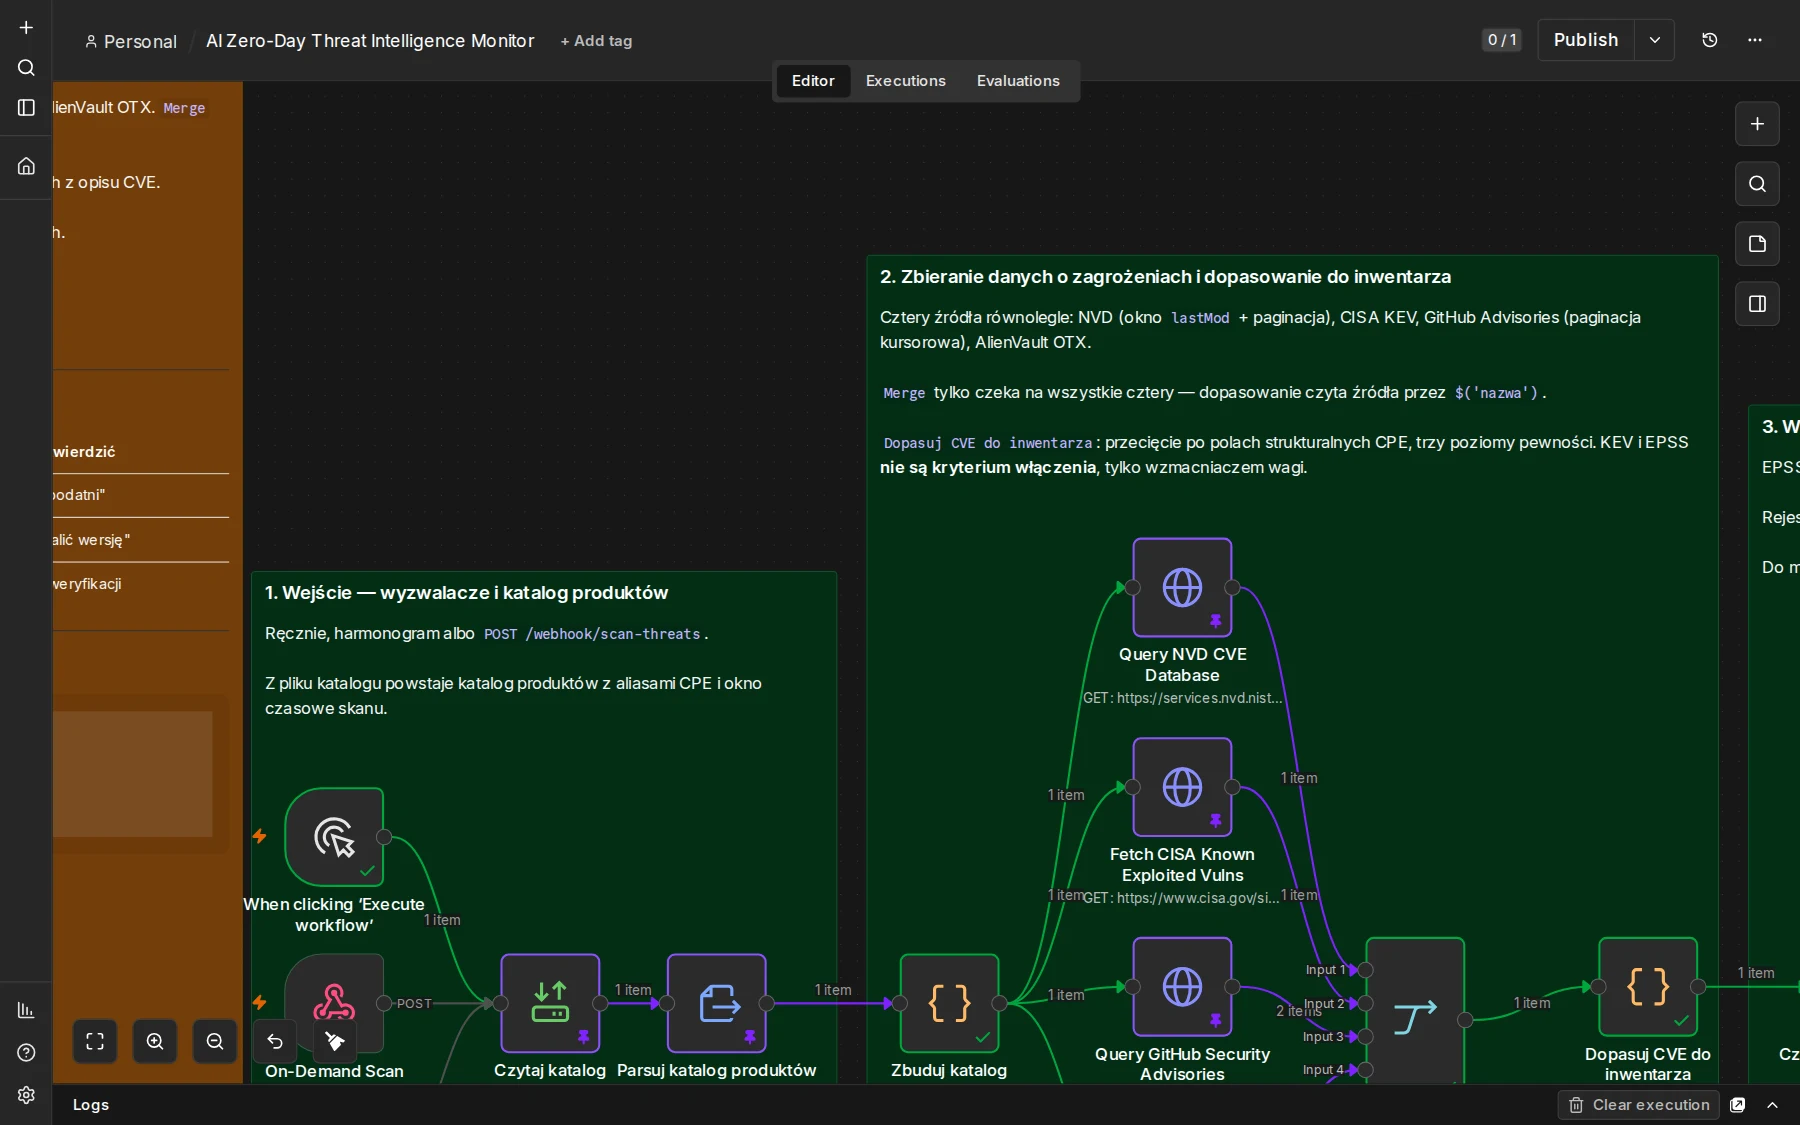
Merge tylko czeka na cztery źródła, a dopasowanie czyta je bezpośrednio, bez kopiowania danych.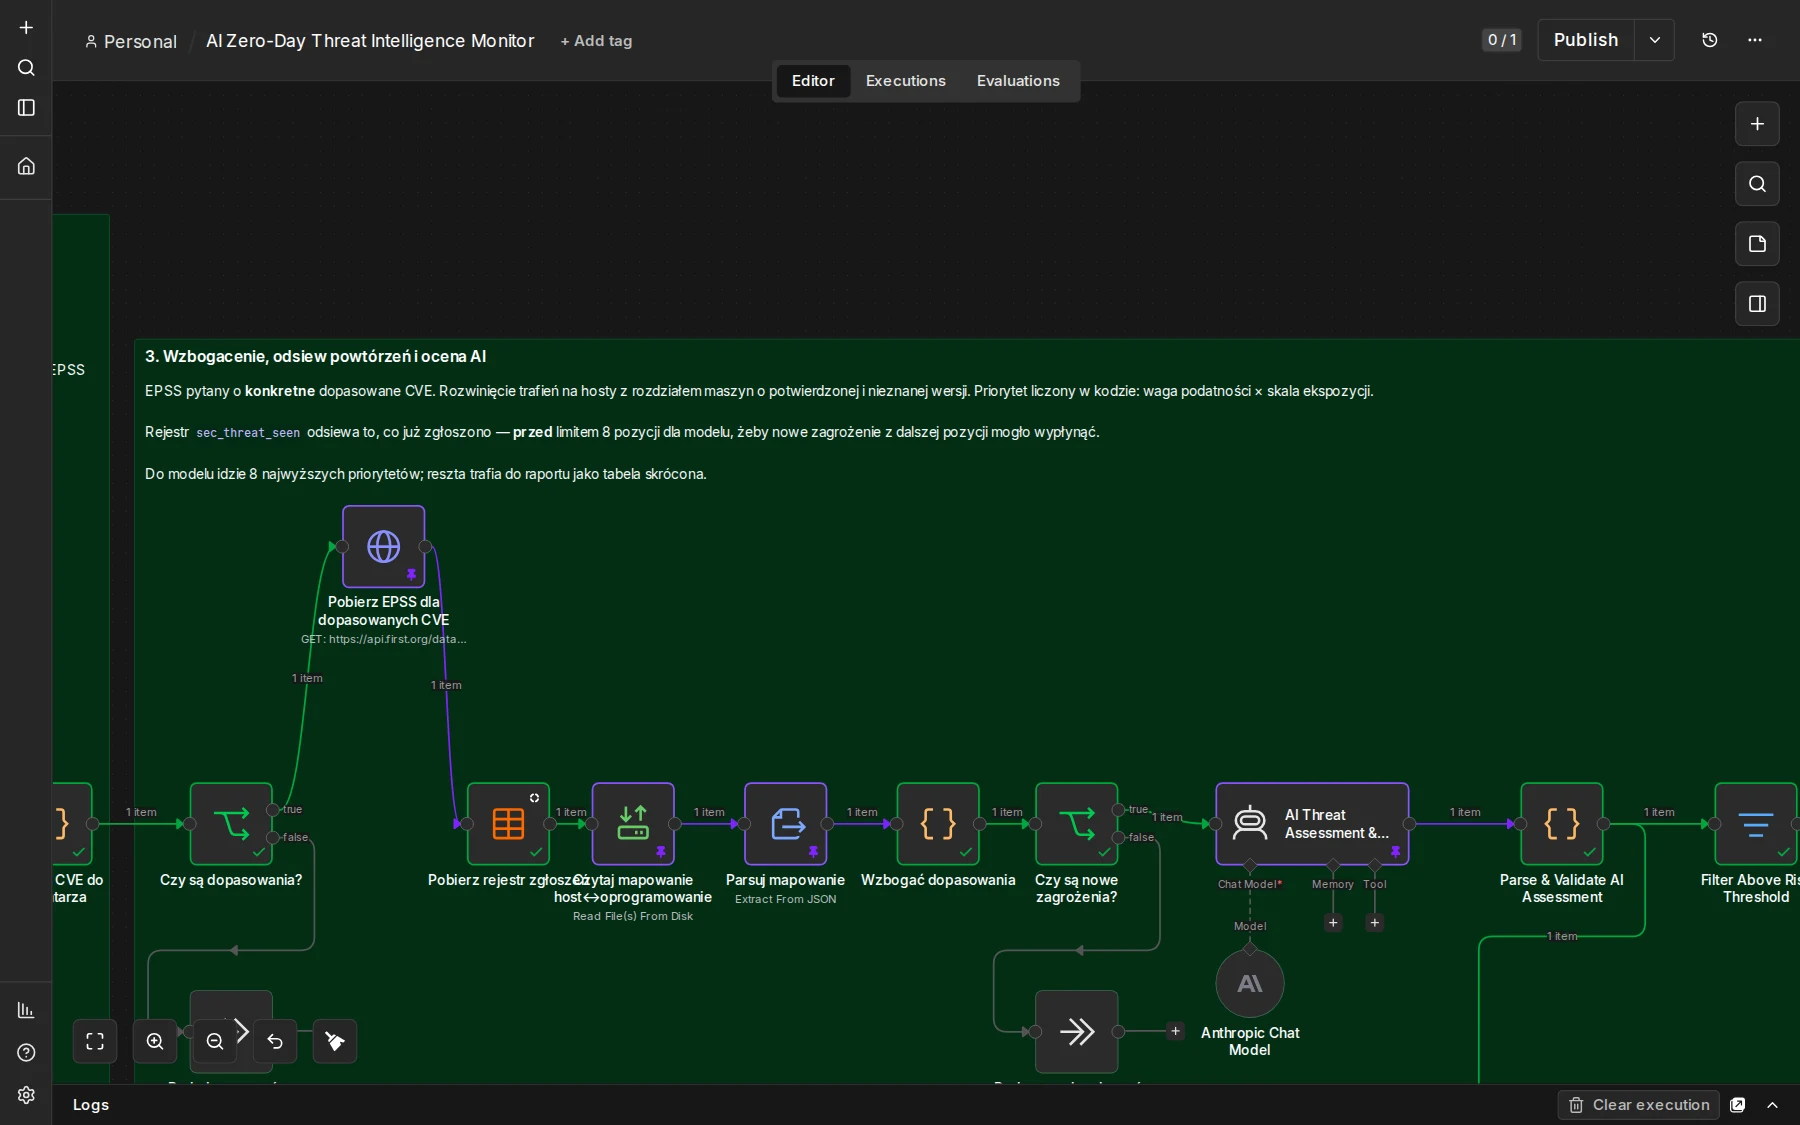
04 / priorytet
Wcześniejsza wersja dodawała płaskie punkty za „cokolwiek wystawione”. Dla hostingu to odwrotność właściwej kolejności: podatność na jednej wewnętrznej maszynie dostawała tyle samo co zdalne wykonanie kodu na setkach serwerów w internecie.
waga = min(CVSS × 8, 80)
+ 25 KEV + 15 EPSS > 0,7
+ 10 brak łatki + 5 OTX
+ bonus dopasowania (10 / 5 / 0)
ekspozycja = publiczne > 0
? min(1; 0,7 + 0,1 · log10(1 + publiczne))
: 0,4–0,6 zależnie od liczby hostów
priorytet = min(100; waga × ekspozycja)
Skala logarytmiczna: 10 i 1000 wystawionych hostów różnią się wyraźnie, ale nie stukrotnie. Model może się z wynikiem nie zgodzić, ale musi uzasadnić różnicę jednym zdaniem.
Liczba „dotkniętych hostów” sklejała maszyny z potwierdzoną podatną wersją i te, o których wiemy tylko, że mają produkt. W skrajnych przypadkach to różnica między kilkunastoma a kilkuset maszynami. Raport podaje obie liczby osobno, a prompt traktuje podanie samej sumy jako błąd.
Jedna maszyna hostingowa ma kilkanaście równoległych wersji PHP. Sumowanie po parach produkt–wersja dawało więcej „hostów publicznych” z PHP niż maszyn w całym inwentarzu. Liczby na poziomie produktu są liczone na zbiorze unikalnych maszyn.
Rejestr zgłoszeń przechowuje odcisk sytuacji: CVE, klasę dopasowania, KEV, pasmo priorytetu i zasięg. Odsiew działa przed limitem 8 pozycji dla modelu, bo inaczej nowe zagrożenie z dziewiątego miejsca nigdy by nie wypłynęło.
05 / precyzja
W bezpieczeństwie fałszywy alarm to realny koszt. Każdy z błędów poniżej ujawnił się na prawdziwym przebiegu i każda poprawka ma test regresyjny na realnych odpowiedziach API zapisanych z produkcji.
| Objaw | Przyczyna | Rozwiązanie |
|---|---|---|
| CVE z 2000 roku jako krytyczne na tysiącach hostów | Stan „wersja poza podatnym zakresem” był sklejony ze stanem „wersji nie znamy”. Wynik negatywny wyglądał jak trafienie. | Trzeci, jawny stan out-of-range: odsiewany, ale liczony w statystykach przebiegu. |
| PHP 7.4 „podatne” na dziurę z PHP 4 | Epoka pakietu (2:7.4) czytana jako numer wersji, więc PHP 7.4 wpadało w zakres „do 4.4.3”. | Normalizacja wersji przed porównaniem i test na realnych rekordach NVD. |
| Alert o Nginx Proxy Manager, którego nie mamy | Doradztwo bez danych CPE dopasowane do naszego nginx przez zdanie w opisie. | Proza wypada z dopasowania. Nazwa pakietu z GitHuba porównywana przez równość całego tokenu. |
| CVE Akki trafiało w hosty z Apache | Alias http_server bez producenta. | Aliasy w formie producent:produkt dla nazw generycznych. |
| Fałszywe trafienia na pakietach z repozytoriów | Dystrybucje backportują poprawki bez zmiany wersji, a NVD porównuje wersje upstream. | Pakiety z repozytoriów obsługuje osobny monitor errat dystrybucji. Ten workflow odpowiada za wczesne ostrzeganie i własne buildy. |
| Świeże CVE „nie dotyczą nas” | Przez kilka dni po publikacji NVD nie ma dla nich danych CPE. | Licznik nvdWithoutCpe w każdym raporcie. Bez CPE i bez pakietu system mówi, że nie wie, zamiast zgadywać. |
06 / AI
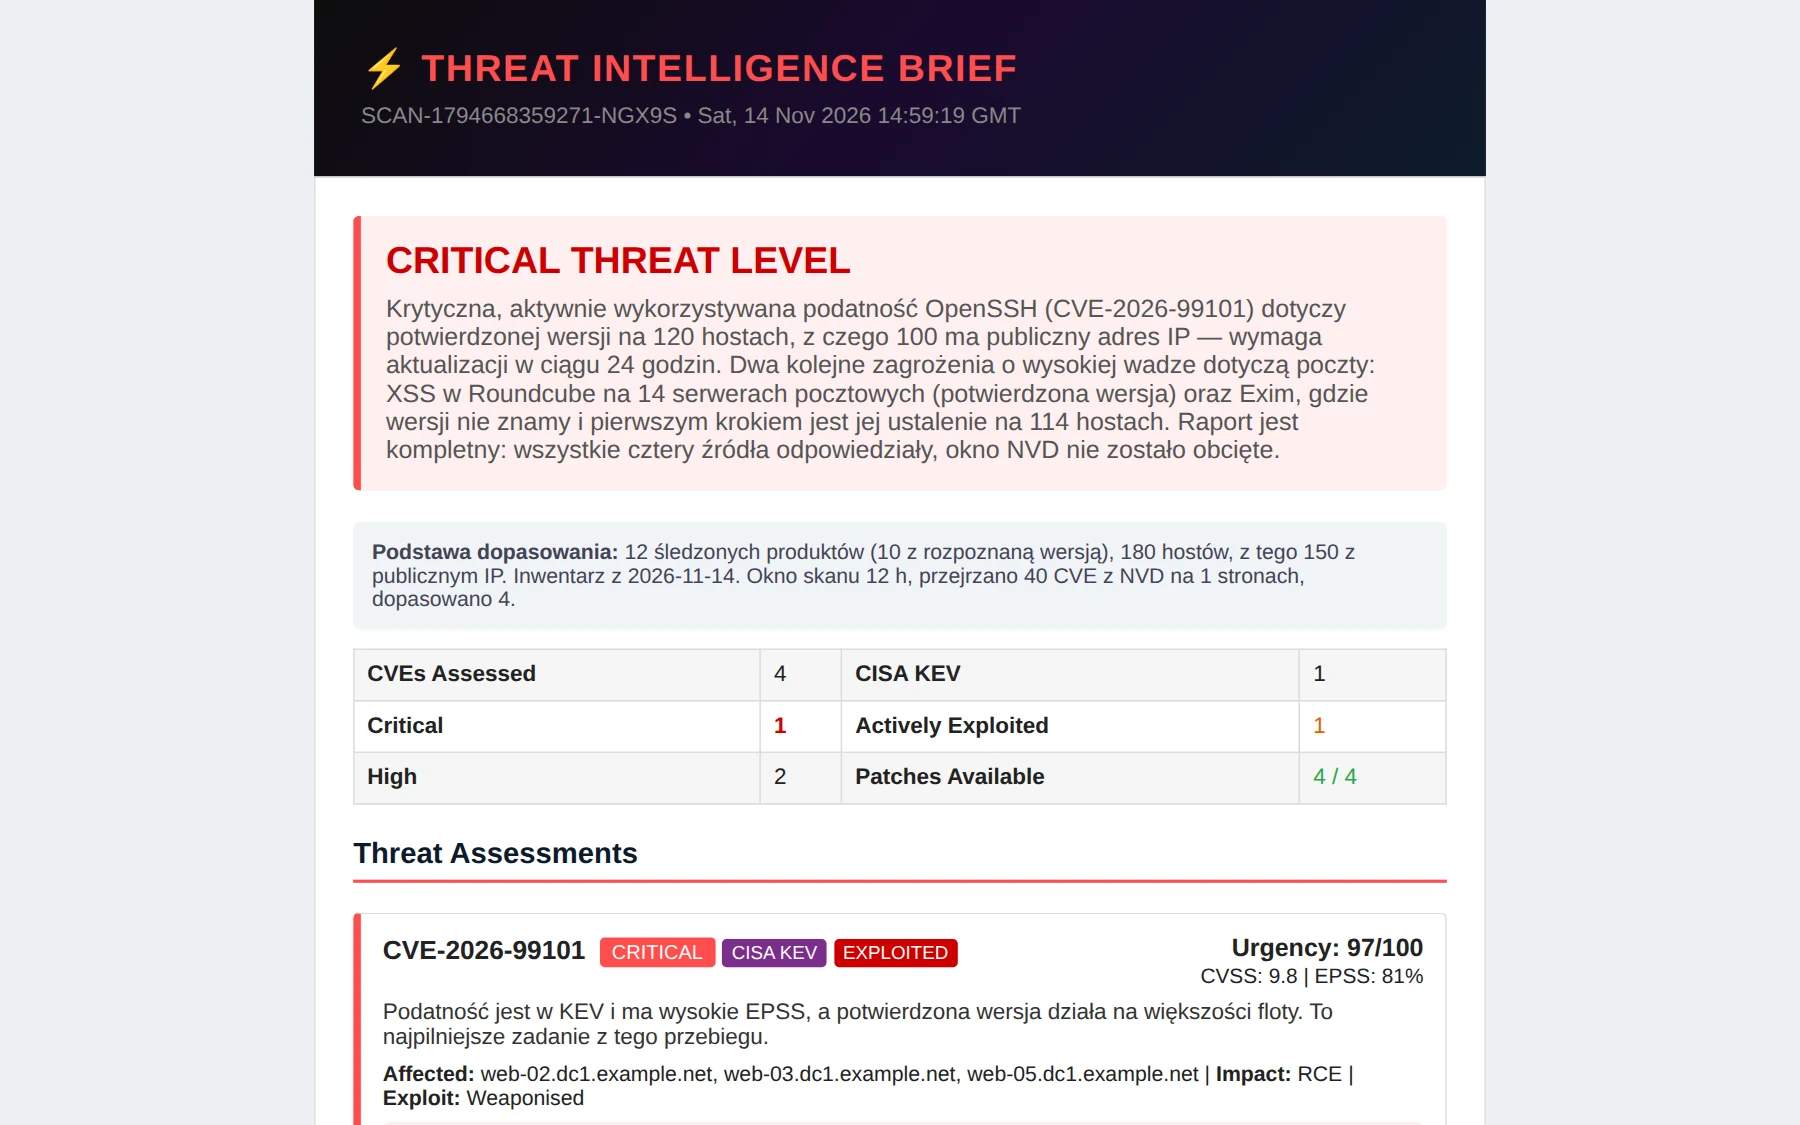
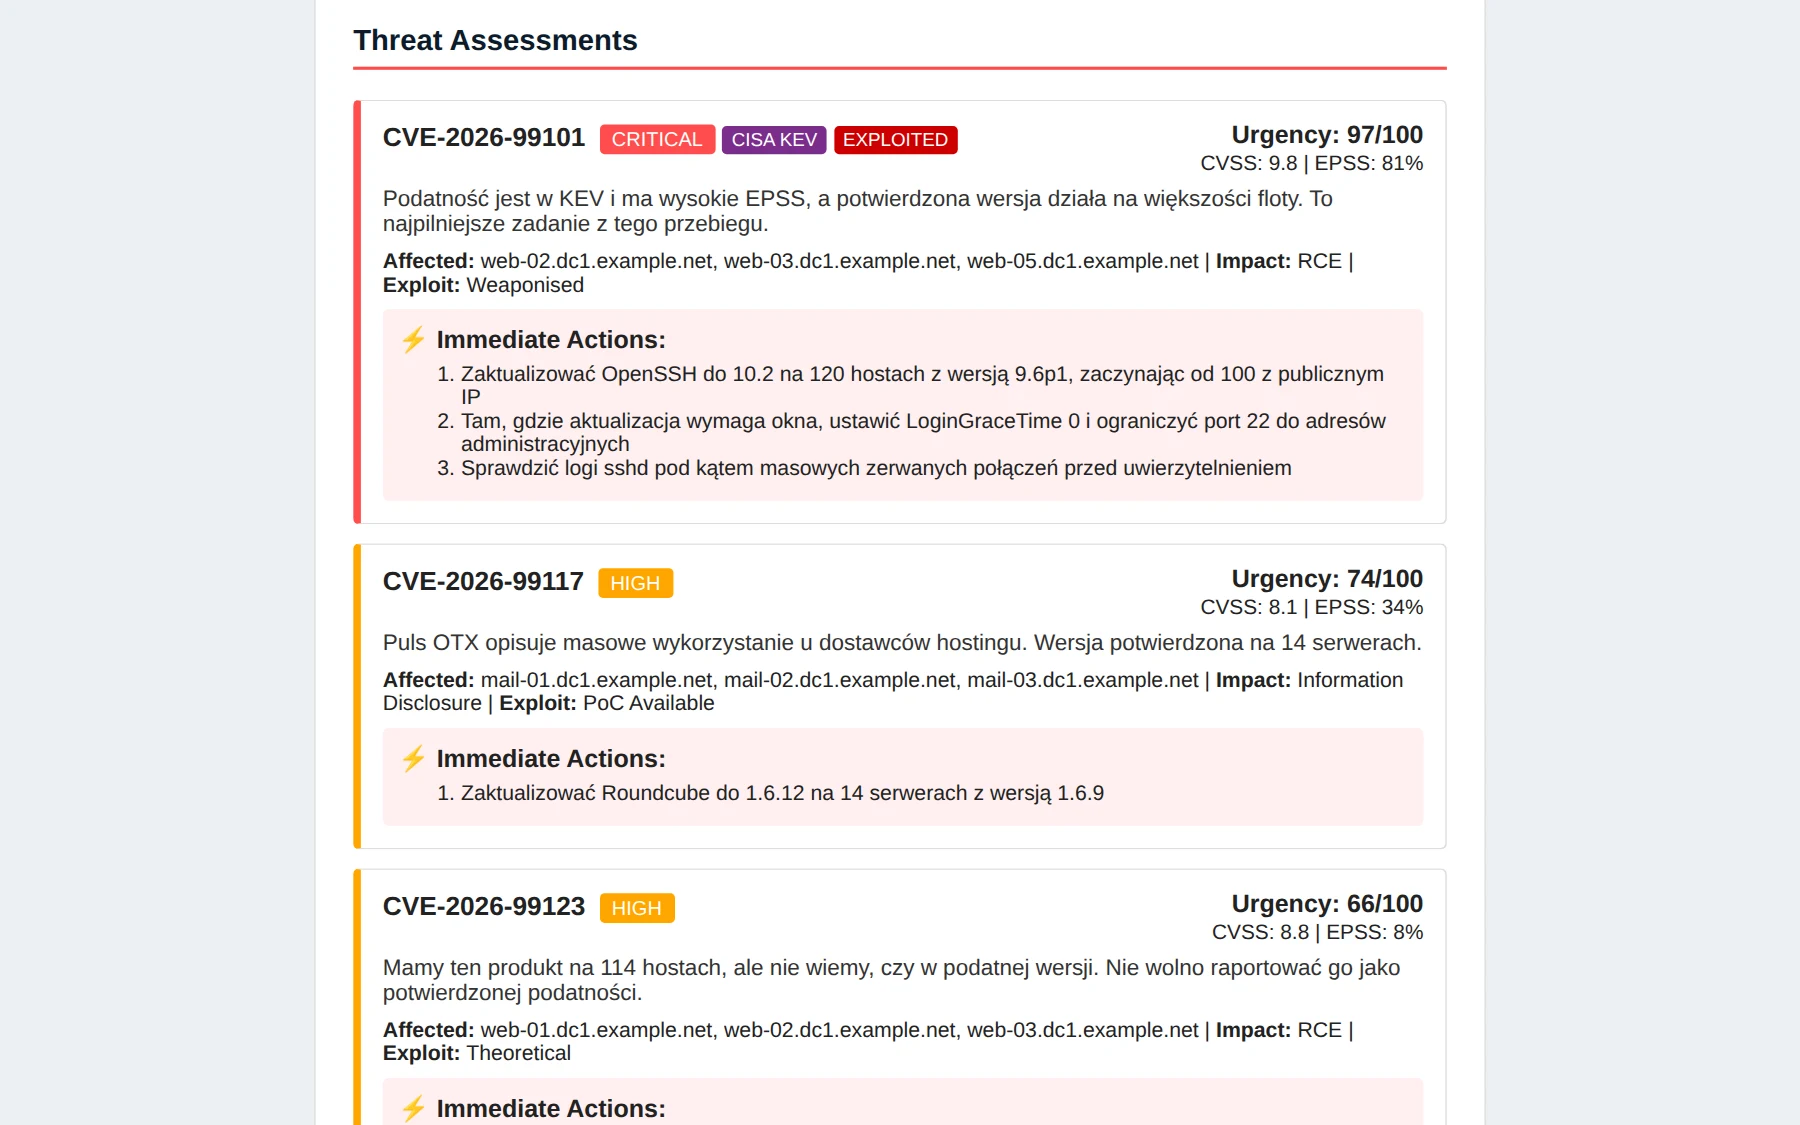
Claude dostaje dopasowane zagrożenia z liczbami hostów i odpowiada za to, w czym jest dobry: ocenę uzbrojenia exploita, wpływu i ruchu lateralnego, działania na najbliższą godzinę, reguły detekcji i mapowanie na MITRE ATT&CK. Nie może „wymyślić” trafienia.
Przy cpe-product model nie może napisać „jesteśmy podatni”. Ma napisać, że produkt występuje i pierwszym krokiem jest ustalenie wersji na wskazanych hostach.
Model używa wyłącznie hostów z próbki przekazanej przez kod, a resztę opisuje jako „i N kolejnych”. Nie podnosi do CRITICAL zagrożenia bez publicznej ekspozycji bez uzasadnienia.
Przy 25 zagrożeniach odpowiedź urywała się w połowie tablicy JSON. Model ocenia 8 najwyższych priorytetów, a pozostałe trafiają do raportu jako zwięzła tabela. Nic nie znika po cichu.
Niedostępne źródło, obcięte okno NVD, CVE bez danych CPE, naprawiony JSON: wszystko trafia do sekcji zastrzeżeń. Kod dokłada je, nawet jeśli model o nich zapomni.
07 / wydajność i niezawodność
Każda przyczyna była inna i każda dotyczy n8n w ogóle, nie tylko tego workflow. Żadna nie była widoczna, dopóki dane były małe.
| Objaw | Przyczyna | Rozwiązanie |
|---|---|---|
Reached heap limit bez zabicia kontenera | Limit sterty V8, nie pamięci kontenera. | Podniesienie sterty Node.js razem z limitem kontenera. Samo jedno nic nie daje. |
| Timeout węzła Code po 300 s | Dopasowanie kwadratowe kompilowało nowe wyrażenie regularne w każdej iteracji. | Indeksy budowane raz: token CPE → produkty, prekompilowane frazy. Ponad 300 s → 0,53 s. |
| 2,6 GB w 90 s i awaria | Odczyt pliku wykonuje się raz na każdy element wejścia: plik 3,2 MB czytany 80 razy. | executeOnce na odczycie i parsowaniu mapowania. Szczyt 673 MB. |
| Setki MB kopii danych | Merge w trybie append przenosił całe okno CVE, a jego wyjście nie było używane. | Tryb „tylko czekaj” z pustym wyjściem. |
| Baza wykonań 420 MB w 3 dni | Każdy przebieg zapisywał pełne wyjścia węzłów, w tym całe okno CVE. | Udane przebiegi bez danych, błędy z pełnymi danymi, retencja i VACUUM: 392 → 45 MB. |
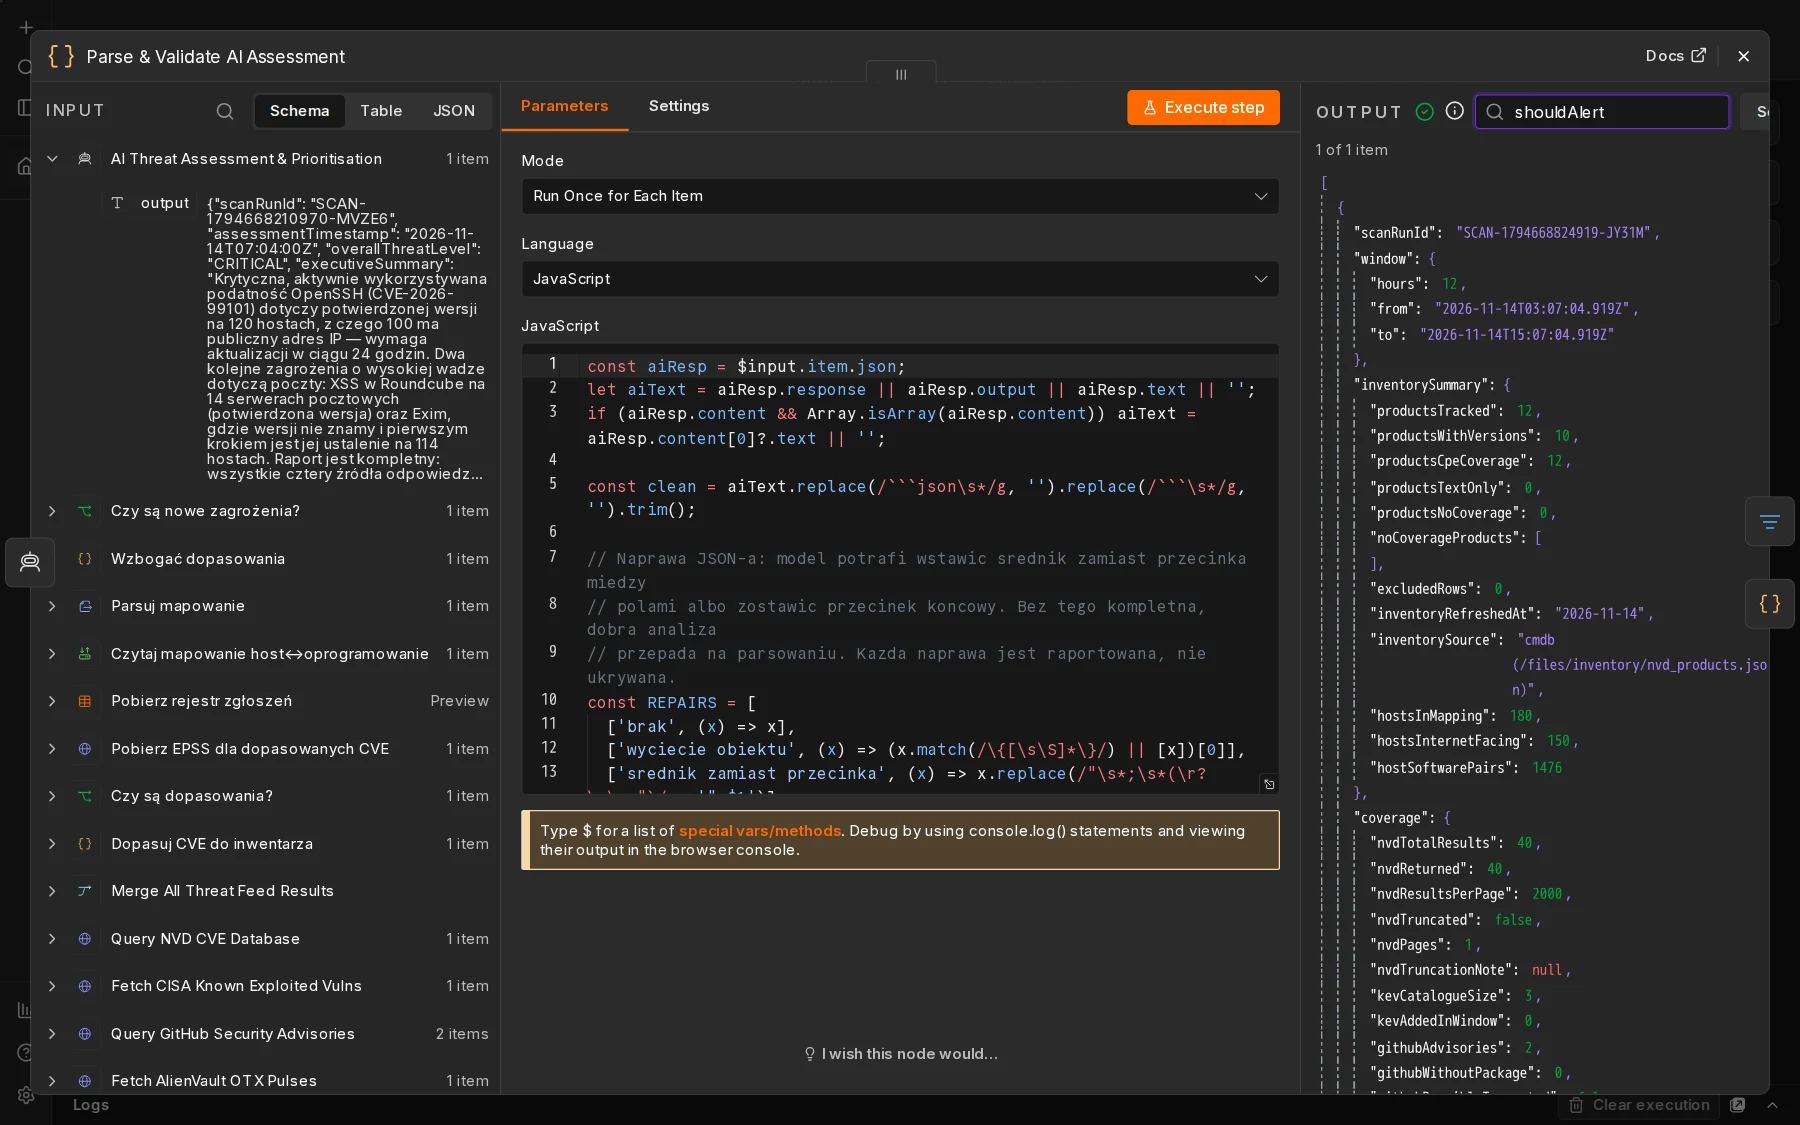
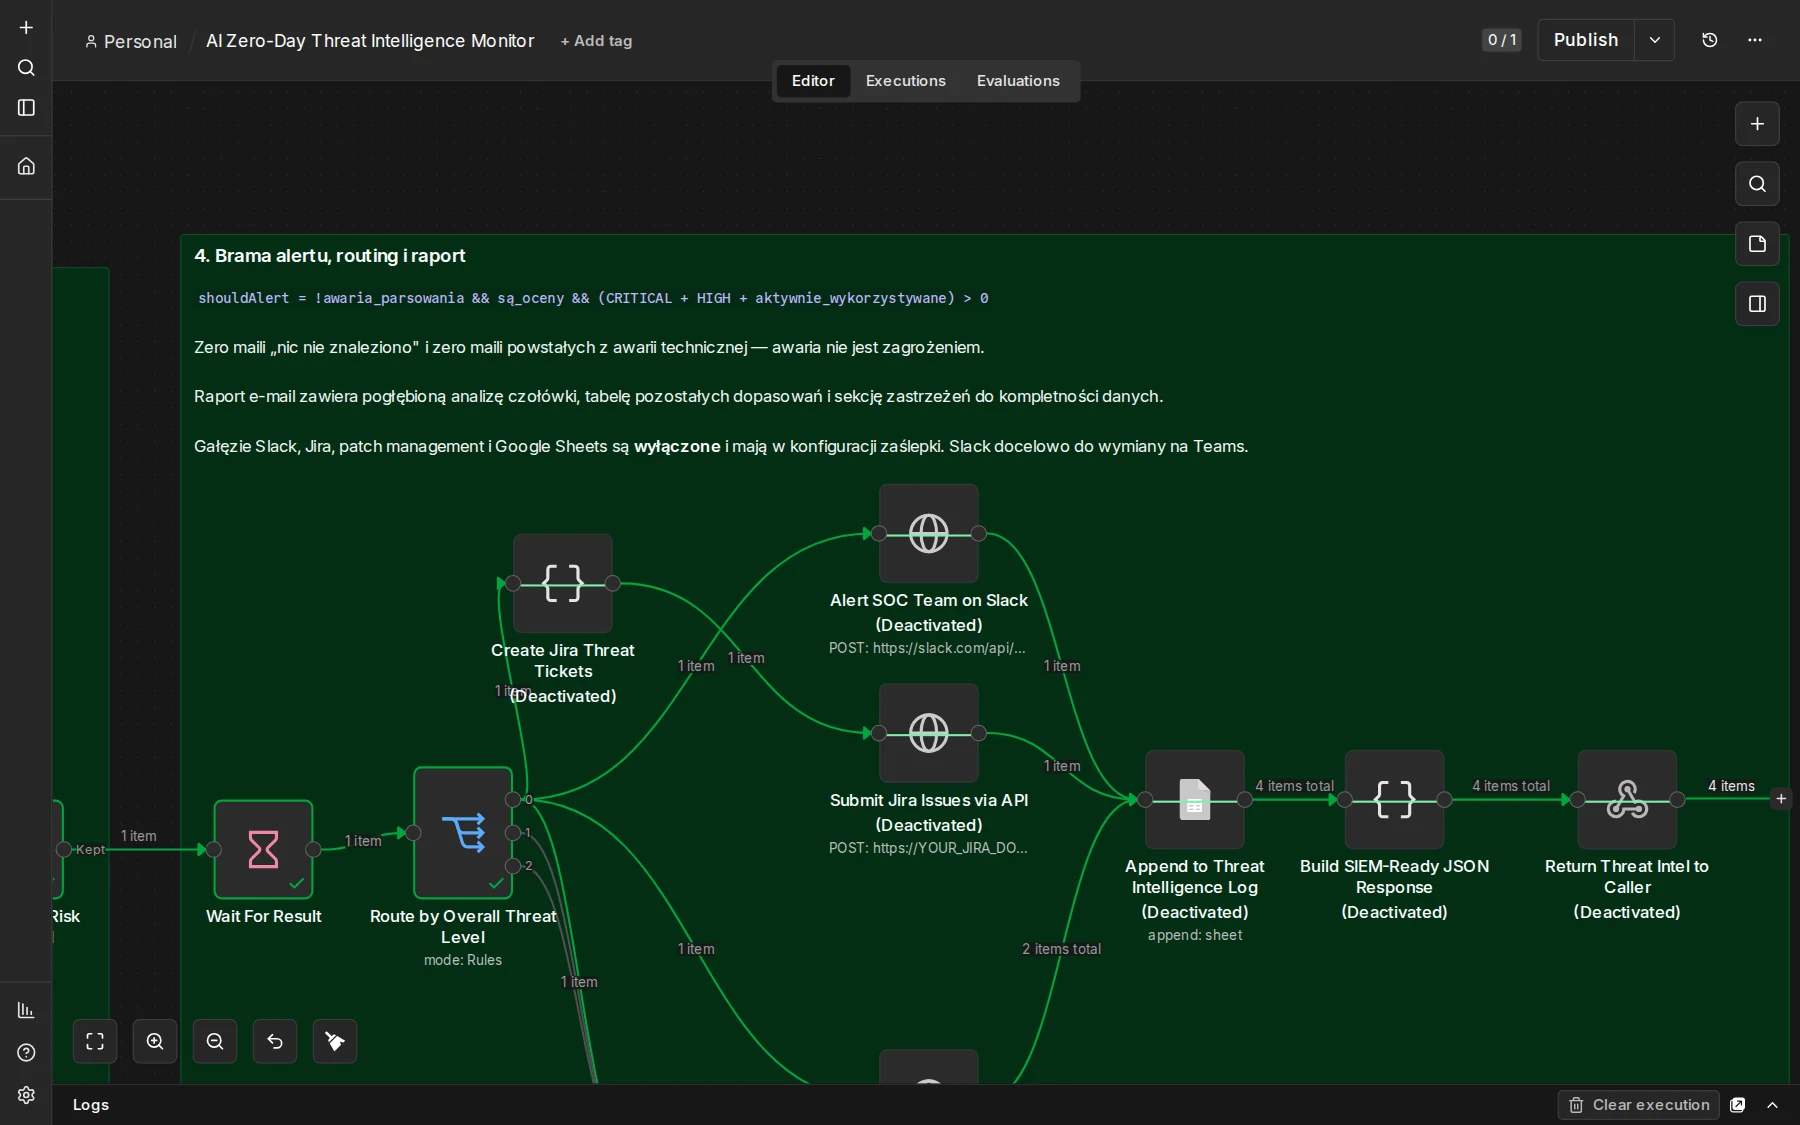
shouldAlert.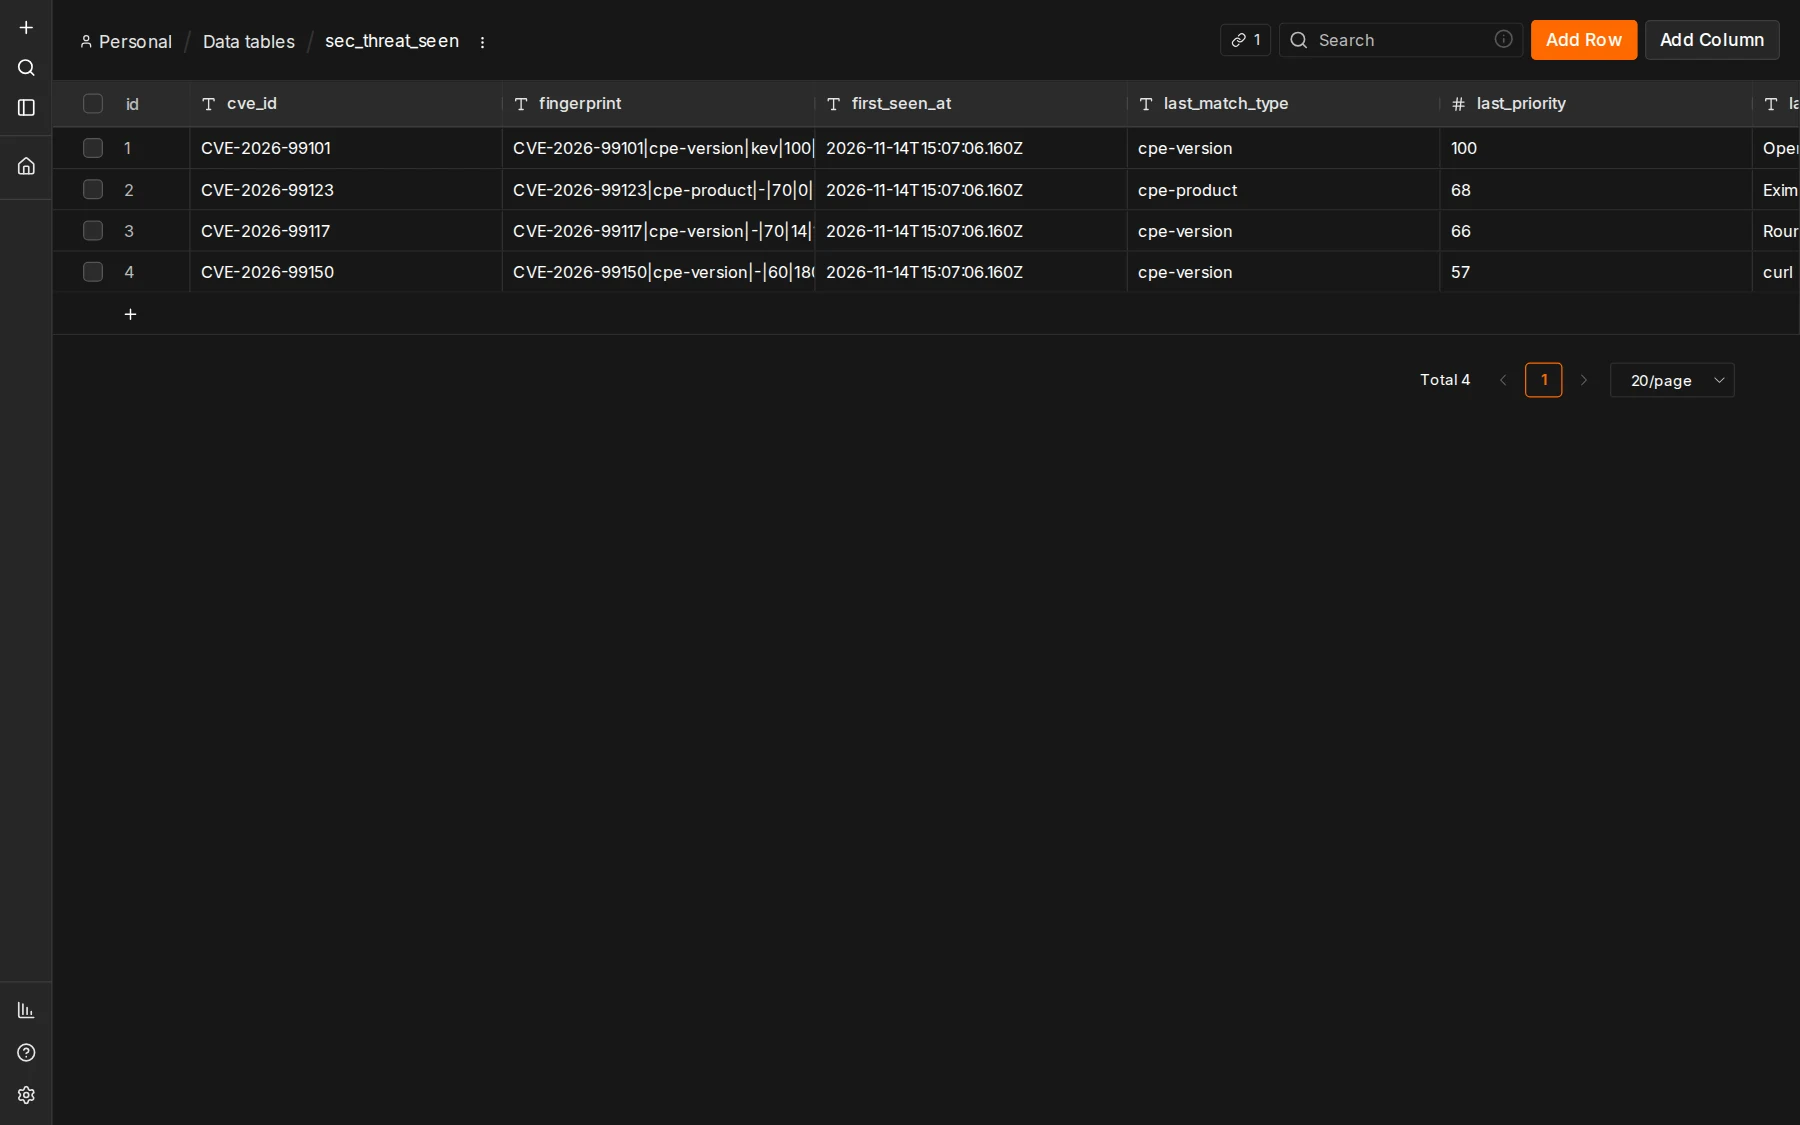
Mail wychodzi tylko wtedy, gdy jest co najmniej jedno zagrożenie krytyczne, wysokie albo aktywnie wykorzystywane, a odpowiedź modelu dała się sparsować. Zero maili „nic nie znaleziono” i zero alarmów z awarii technicznej.
Gdy parsowanie odpowiedzi modelu padnie, nic nie trafia do rejestru jako „widziane”. Te same CVE wrócą w następnym przebiegu, zamiast zniknąć na zawsze.
08 / bezpieczeństwo wdrożenia
n8n nie jest wystawiony do internetu. Izolacja wynika z mapowania portów Dockera, więc nie zależy od tego, czy firewall hosta jest włączony.
Klucze NVD, GitHub i OTX przeniesione z nagłówków węzłów do credentiali z listą dozwolonych domen. Sekret nie zostanie wysłany nigdzie indziej, nawet podpięty pod inny węzeł.
Wbudowany audyt wykrył tylko nagłówek Authorization. Klucze w nagłówkach o niestandardowych nazwach przeszły niezauważone. Audyt to sito, nie dowód czystości.
Pełne eksporty inwentarza leżą w katalogu z prawami tylko dla właściciela, poza montowaniem kontenera. Do n8n trafia wyłącznie to, czego workflow potrzebuje. Webhook wymaga tokenu w nagłówku.
09 / wdrożenie
Punktem wyjścia był workflow, który formalnie działał, ale pytał NVD jednym hasłem, korelował po słowach i pobierał globalny top EPSS bez związku z inwentarzem. Pierwszy krok to pomiar, co faktycznie trafia do raportu.
Okno CVE pobierane raz, z paginacją NVD i kursorami GitHuba, przecinane lokalnie z całym katalogiem. Pokrycie każdego kanału liczone i raportowane.
Dopasowanie po CPE z kwalifikacją producenta, zakresy wersji, trzy poziomy pewności, potem stan „poza zakresem” i usunięcie prozy z dopasowania po pierwszych przebiegach na pełnym inwentarzu.
Waga razy ekspozycja, rozdział hostów potwierdzonych od możliwych, rejestr odsiewu, limit dla modelu z tabelą reszty i brama alertu.
Indeksy, executeOnce, retencja wykonań, klucze w credentialach, token webhooka. Przy przejściu na modele Claude 5 trzeba było podnieść wersję węzła modelu, bo stara wysyłała nieobsługiwany tryb myślenia.
technologie
Dane klienta są zanonimizowane. Zrzuty pochodzą z odizolowanej kopii workflow uruchomionej na fikcyjnym inwentarzu (180 hostów w domenie example.net) i przykładowym oknie CVE: identyfikatory CVE-2026-99xxx, opisy, hosty i odpowiedź modelu są fikcyjne, a adresy, nazwy serwerów, ścieżki i dane dostępowe zostały zastąpione. Logikę dopasowania, wzbogacenia i raportu na zrzutach wykonał prawdziwy kod workflow. Liczby w sekcjach 02 i 07 pochodzą z pomiarów na produkcji, a przykłady błędów z prawdziwych przebiegów.
następny krok
Opisz, co chcesz osiągnąć. Wrócę z konkretną propozycją, wyceną i planem wdrożenia.